Cursor 规则文件怎么配置才更懂你的代码与上下文
很多团队接入 Cursor 后发现,补全和建议仍然像在写陌生项目,频繁出现不合约定的变量名和过时写法。核心结论是:Cursor 是否"懂你的代码",不取决于模型本身,而取决于你有没有把项目约定写进规则文件。配置好规则文件,补全会更贴合你的命名风格、目录结构和业务边界;没配置,它就只能给出通用答案。最该做的三件事是:写一份讲清技术栈与禁忌的全局规则、按目录补充团队约定、再用真实补全验证规则是否真的生效。下面从配置到验证逐步讲清,并标出新手最常踩的几个误区。
一、规则文件解决什么问题:让补全更懂项目
Cursor 这类 AI 编程工具默认只看到当前打开的文件,对项目的整体约定一无所知。当你在写一个 Python 服务或者 Django 后台管理模块时,如果没有规则提示,它可能会用另一种风格的函数签名,甚至引用项目里根本不存在的字段。规则文件的作用,就是把这些隐含约定显式告诉模型,让它的代码补全和解释具备上下文感知能力,而不是每次都从零猜测。想了解同类工具的日志排查,可以看 TRAE 日志排查文档。
# 全局规则
- 技术栈:Node.js 18 + TypeScript + React
- 组件用函数式写法,禁止 class 组件
- 所有接口错误用统一的 ApiError 抛出
- 不要引入未在项目里声明过的第三方包
上面这份规则虽然简单,却直接约束了补全的边界。规则文件本质上是给模型的"项目说明书",它不会自动读取你的 ESLint 配置,所以你要主动把硬性约定写进去。上下文感知能力不是模型凭空获得的,而是你喂给它的项目事实决定的。配置规则文件,是成本最低、收益最明显的第一步。
二、最小可用配置:先写一份全局规则
入门阶段不需要写很厚,一份讲清四件事的全局规则就够用:技术栈与版本、目录约定、命名规范、明确禁止的行为。这四个维度覆盖了八成日常补全出错的原因。比如你团队规定接口返回必须是 { code, data, msg } 结构,就把这条写进规则,Cursor 在生成请求代码时就会主动对齐,而不是随手返回 result。遇到不确定的排查项,可参考 TRAE 问题排查文档。
# 项目规则
- 使用 Git 提交,commit 用中文简述意图
- 数据库变更必须走迁移脚本,禁止手改线上表
- 敏感配置读环境变量,不得硬编码
规则要写"可执行的约束",而不是空泛的"写得好一点"。越是具体的禁令,模型越不容易违反。新手常犯的错是把规则写成"请写出高质量代码",这种话对模型几乎没有约束力。真正有用的规则像"禁止硬编码密钥""函数不超过 60 行",是模型能直接对照执行的。写好第一份规则后,先拿一个小需求测试补全是否符合预期,再逐步补充。
三、按目录细分:把团队约定写进项目规则
当项目变大,全局规则就不够细了。你可以为不同目录写专属规则,例如在 src/api/ 下规定所有请求走统一封装,在 src/components/ 下规定组件必须接受受控属性。这样 Cursor 在对应目录补全时,会自动套用更贴身的约定,而不是只凭全局规则泛泛而写。版本控制习惯可以先看 Git 版本控制教程。
# src/api/ 目录规则
- 所有请求经 request.ts 封装,禁止直接 fetch
- 路径参数用 :id,不要拼字符串
- 超时统一 10 秒,失败走拦截器提示
目录级规则的价值,是让模型理解"同一个项目里不同位置的写法可以不一样"。比如工具函数和页面组件对异常的处理方式不同,分目录约束后,补全会更像团队里真正有经验的同事。用 Cursor 写 Python 或 Django 这类后台管理项目时,把路由、模型、序列化各自的约定分开写,模型产出的代码几乎不需要大改。规则越贴近真实分工,生成的代码质量越高。
四、验证是否生效:看补全与解释是否贴合
规则写完后,最容易被跳过的一步是验证。很多人配完就以为万事大吉,结果模型照样写出违背规则的代码。验证方法很简单:故意问一个会触发禁令的场景,比如"帮我直接 fetch 一个接口",看 Cursor 是否按规则改用封装函数。如果它仍然违规,说明规则没被加载,或者写法太弱没被识别,这时要回看文件位置和格式。更稳妥的做法是,配完规则后立刻运行一条会触发禁令的补全命令,检查模型是否真的改用封装函数,而不是等上线后才发现跑偏。想补 Python 基础,可以看 Python 基础教程。
你:在 src/api 里直接 fetch('https://api.test/user')
Cursor:根据目录规则,应走 request.ts 封装,下面是对照写法 …
验证不只看补全,还要看解释。把一段老代码丢给 Cursor,观察它的解释是否用到了你写的项目术语,而不是泛泛而谈。如果解释里出现了你规则里定义的模块名和约定,说明规则已经真正生效。一个实用的习惯是:每加一条规则,就配一条对应的检验问题,确认模型确实读进去了。规则文件不是写完就完,而是要在真实补全里反复校准,才能长期保持贴合。
五、常见配置误区:别把规则写成说明书
最后一个容易踩的坑,是把规则文件写成冗长说明书,塞进几十条规定,结果模型反而抓不住重点。规则太多会稀释关键约束,模型在长上下文里容易忽略中间内容。更糟的是,有人把和业务无关的颜色、字体这类纯视觉偏好也写进去,既占上下文又无助于代码质量。正确做法是保持精简,每条规则都能在补全里被直接检验,定期删掉那些从没被触发过的条目。
# 反例:过于空泛
- 请尽量写出优雅、可维护、高性能的代码
# 正例:可检验
- 禁止在循环里发起网络请求
另一个误区是只在全局写规则,忽视目录细分,导致核心模块和边缘脚本被同一套约束框死。规则文件是手段不是目的,它的目标是让 Cursor 的代码补全稳定贴合团队实际,而不是堆砌漂亮话。配置完成后,用一段时间内的真实改动回看:如果仍有大量返工,说明规则还没写到痛点上,继续收窄即可。
总结
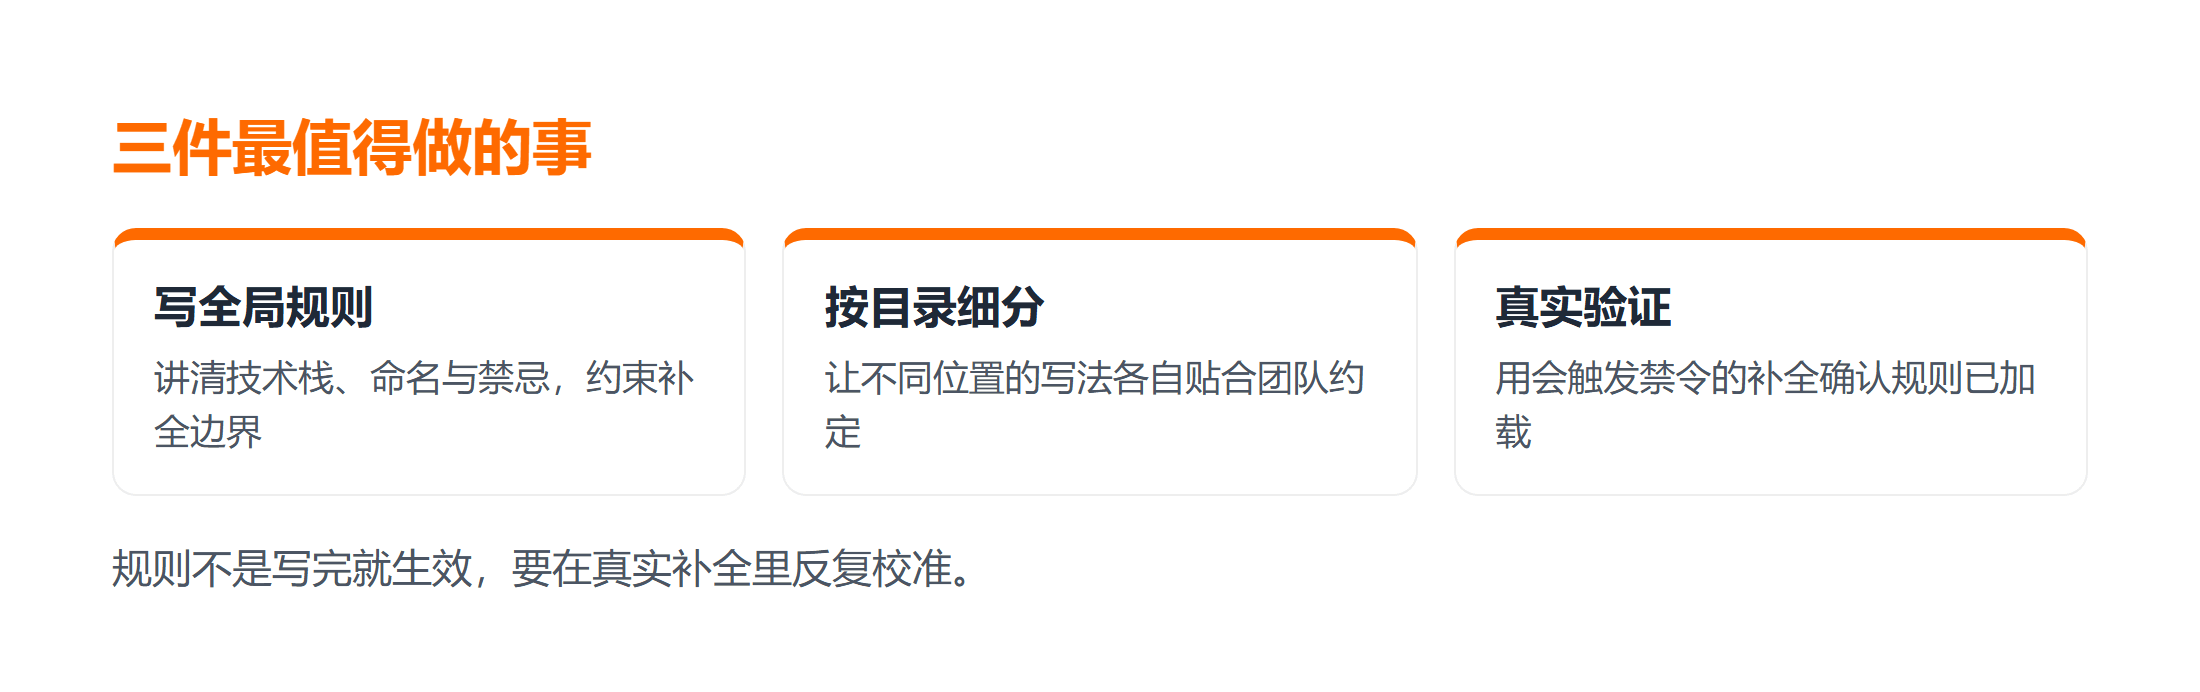
Cursor 规则文件不是接入即生效的开关,而是一份需要你持续维护的"项目约定清单"。配置好它,模型的代码补全和解释才会具备真正的上下文感知,而不是每次都从零猜测。三件最值得做的事:第一,写一份讲清技术栈、命名与禁忌的全局规则;第二,按目录补充团队专属约定,让不同位置的写法各自贴合;第三,用真实补全和解释验证规则是否真的被加载。
避坑的关键在于克制:规则要写可检验的硬约束,别写成空泛说明书,也别把视觉颜色这类无关项塞进去。用 Cursor 写 Python、Django 这类后台管理项目时,把路由、模型、序列化分开约束,收益尤其明显。规则文件配完不是终点,把它当成随项目演化的活文档,每隔一段时间回看补全质量,该删删、该补补,才能真正让工具更懂你的代码与上下文。从适用边界看,规则文件对多人协作的中大型项目收益最大,对个人一次性脚本则意义有限,别为了用而用。
常见问题
Q:规则文件写在哪里才会被 Cursor 读取?
通常是项目根目录下的规则文件或配置入口,具体位置随版本略有差异。无论放在哪,配完都要用一条会触发禁令的提问验证它确实被加载,而不是写完就默认生效。
Q:一份规则写多少条比较合适?
以"能直接检验"为尺度,几条到十几条足够。规则过多会稀释重点,模型在长上下文里反而容易忽略中间条目,所以定期清理从未触发的规则很有必要。
Q:目录级规则和全局规则冲突时听谁的?
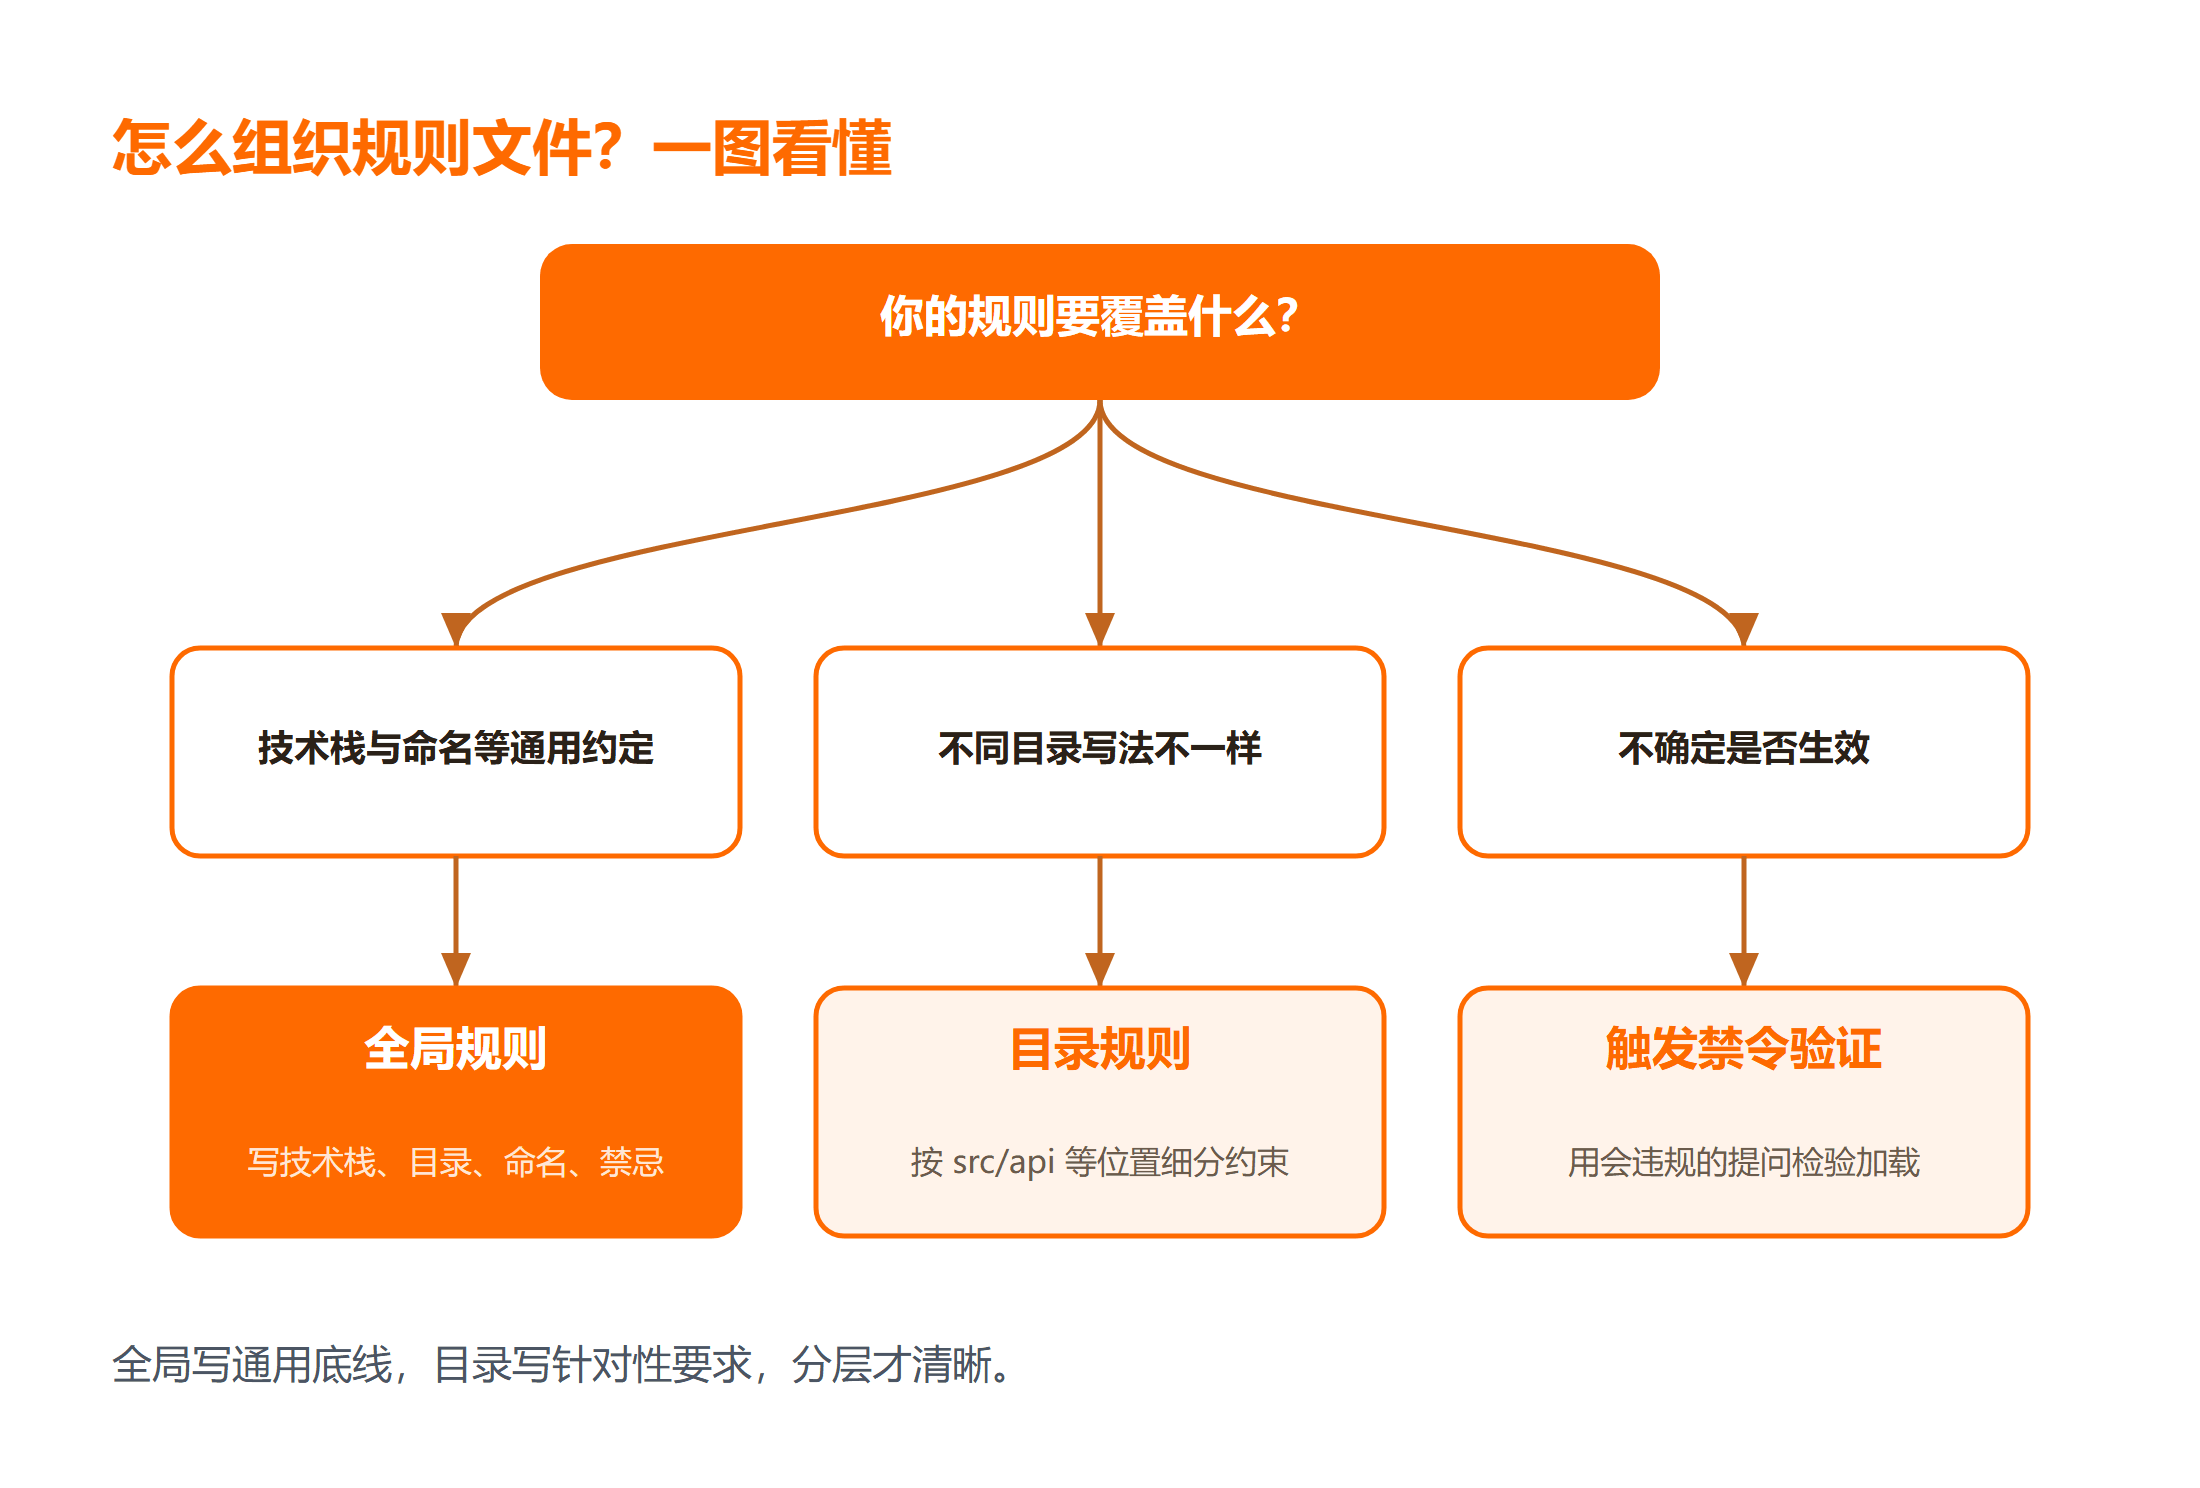
一般目录级规则优先级更高,因为它更贴近具体位置的约定。配置时避免两者直接打架,全局写通用底线,目录写针对性要求,分层才清晰。