SQL 模糊查询:3 种写法一次讲清,从最小示例讲到边界
SQL 模糊查询的核心就三种写法:前缀用 LIKE 'x%'、包含用 LIKE '%x%'、查符号本身用 ESCAPE 转义。LIKE 运算符配合百分号和下划线两个通配符,在 WHERE 子句里按"开头、包含、单字符"三种模式匹配文本,当你记不清完整内容、只想按片段找数据时,它比等号精确匹配灵活得多。本文基于 MySQL 8.0 与标准 SQL 验证,把三种最常用写法从最小示例讲到性能边界,并附上索引与版本差异提醒。今天这篇文章,编程狮就把这块讲透。
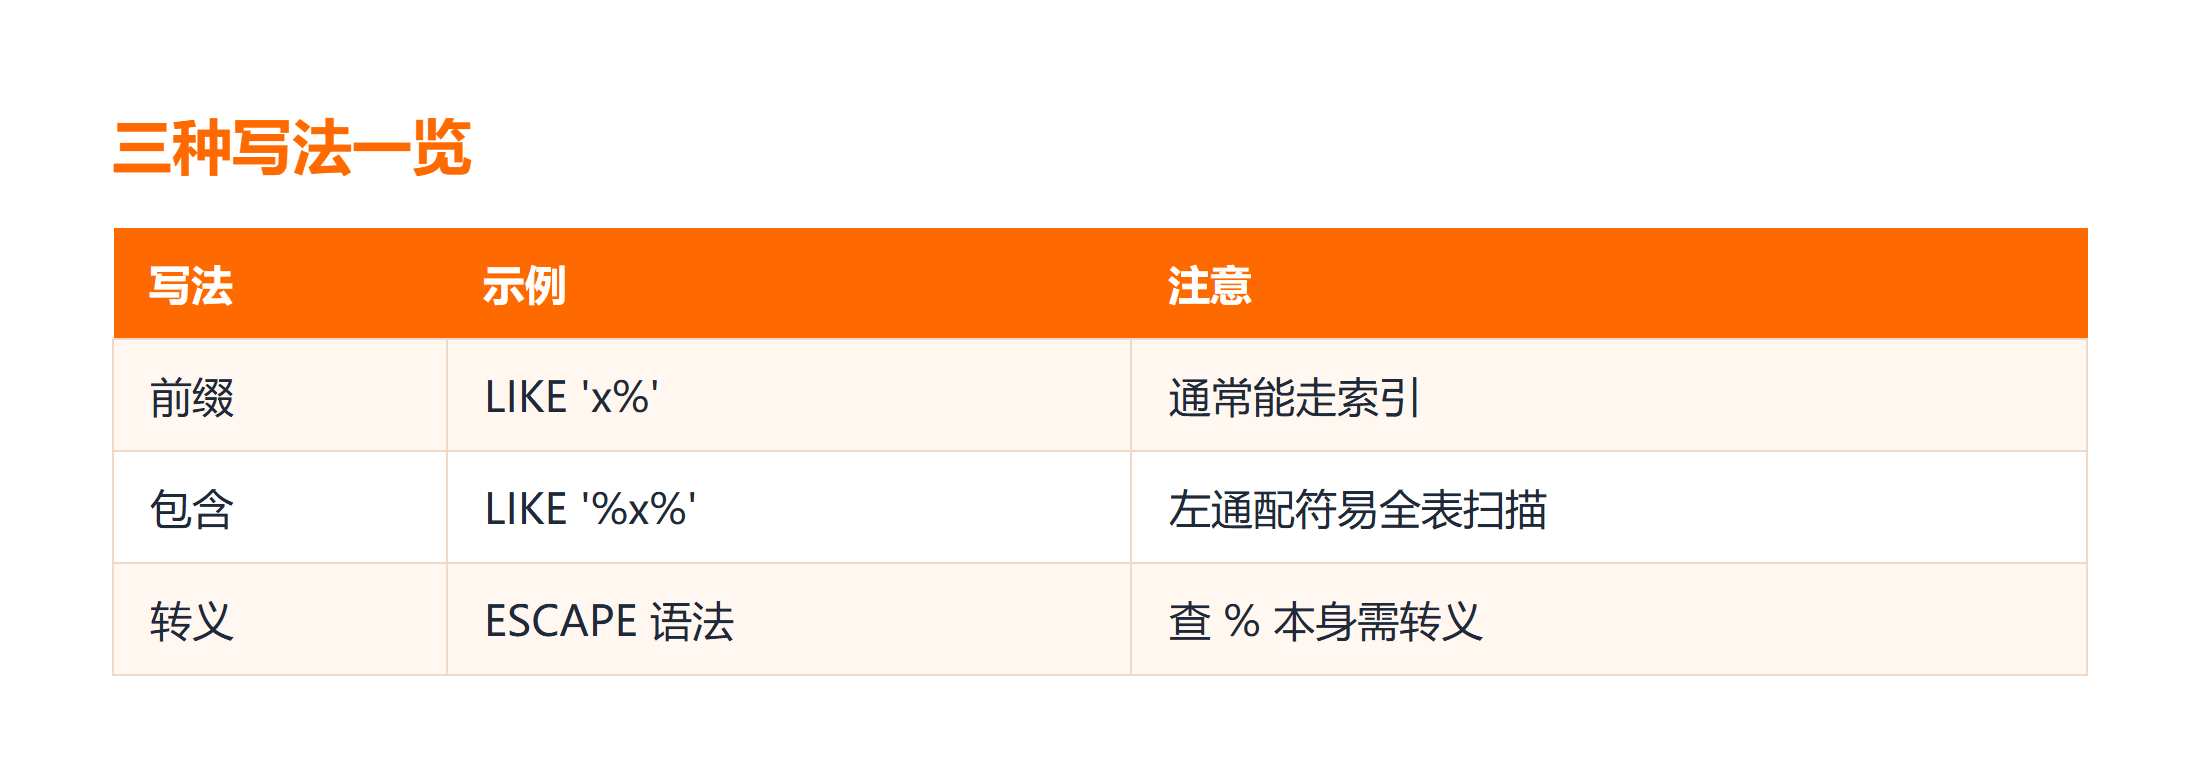
先看结论
| 你想查的 pattern | 写法 | 说明 |
|---|---|---|
| 以某串开头 | LIKE '张%' |
前缀匹配,能用到索引 |
| 包含某段 | LIKE '%手机%' |
包含匹配,左通配符会扫全表 |
| 含 % 或 _ 本身 | LIKE '%\%%' ESCAPE '\' |
转义后查特殊字符本身 |
一句话:开头用前缀、中间用包含、遇到符号本身要转义,三种写法覆盖绝大多数模糊匹配需求。
一、LIKE 运算符与两个通配符(基础)
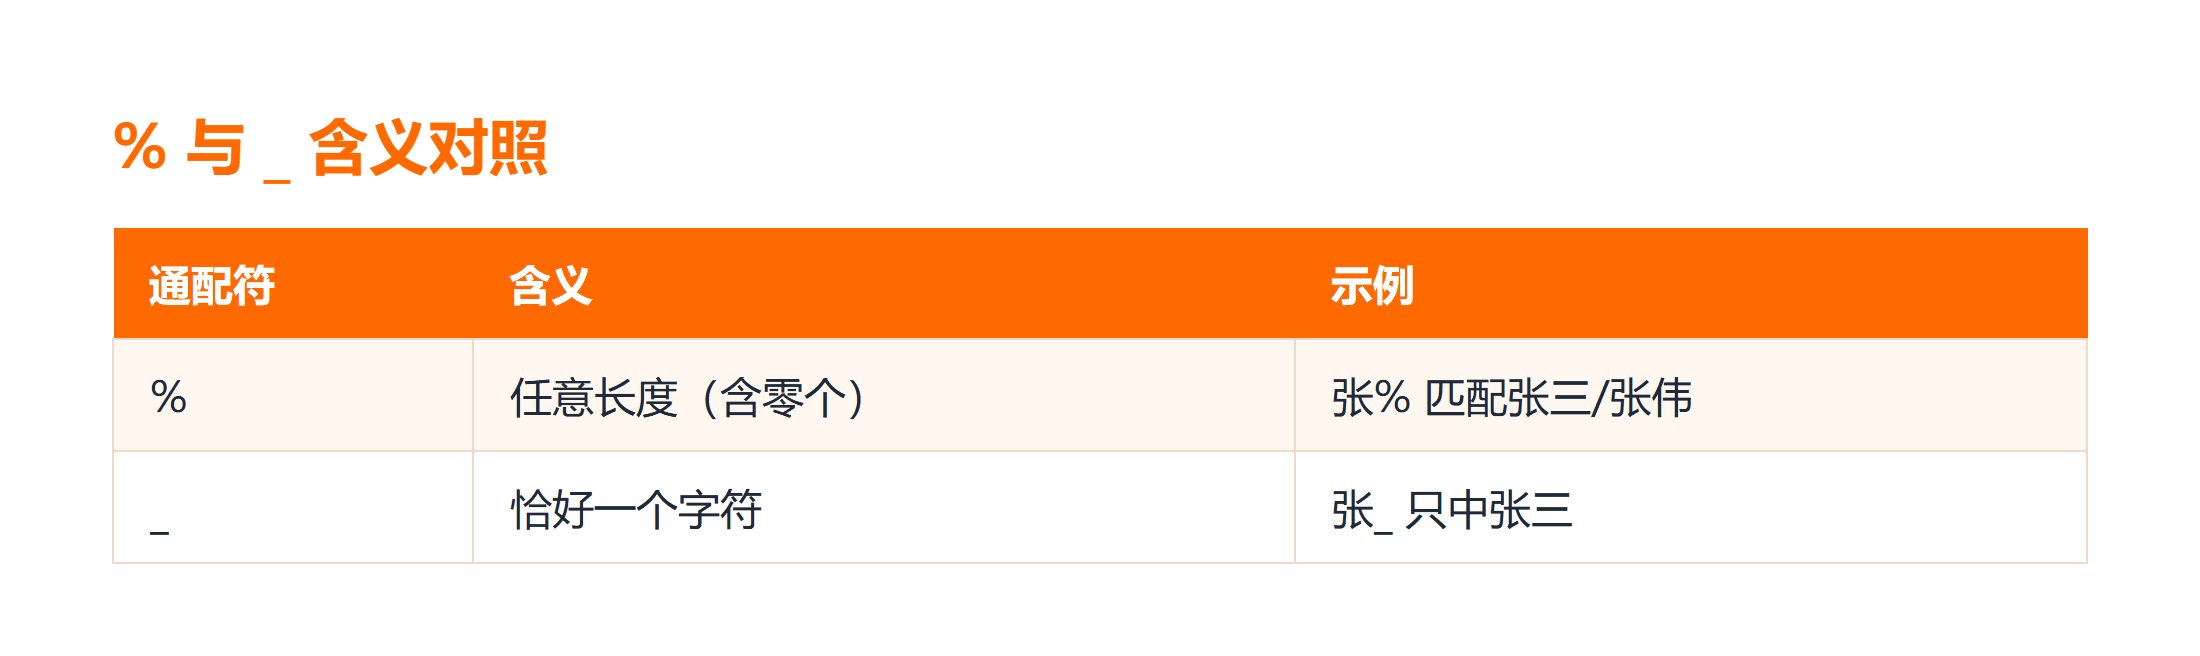
LIKE 运算符是 SQL 标准的模糊匹配工具(基础语法可参考 SQL 教程),它只在字符类型列上工作,数字列要先转成字符串才能用。它认识两个通配符:百分号(%)代表"任意长度任意字符",下划线(_)代表"恰好一个任意字符"。这两个通配符是模糊匹配的全部基石,后面所有写法都是它们的组合,下一段我们直接上最小示例。
-- 查找姓"张"的所有记录:张后面可以是任意内容
SELECT name FROM users WHERE name LIKE '张%';
上面这段运行后会返回所有 name 以"张"开头的行。预期结果是诸如"张三""张伟"这类记录;如果你写成 LIKE '张_',则只匹配"张"加一个字,比如"张三"能中、"张伟明"不中。以上语句为说明写法,未执行,请以你的数据库实测为准。
实际使用中,LIKE 是否区分大小写由列的排序规则(collation)决定:以 _ci 结尾的规则不区分大小写,_bin 则区分。如果你的查询在某台服务器能查到、另一台却查不到,优先怀疑两边的 collation 不一致,而不是 SQL 写错。
💡 小提示:通配符只在 LIKE 里才有特殊含义,在等号比较里它们就是普通字符,别混用。
二、前缀匹配与包含匹配:两种最常用写法
前缀匹配用 LIKE 'abc%',表示"以 abc 开头"。因为匹配从字符串首字符开始,大多数数据库能让它走列上的 B+Tree 索引,数据量大时也很快。包含匹配用 LIKE '%abc%',表示"任意位置包含 abc",但左侧的 % 让优化器无法定位起点,往往会退化为全表扫描。
-- 写法一:前缀匹配,找所有以"138"开头的手机号
SELECT phone FROM customers WHERE phone LIKE '138%';

-- 写法二:包含匹配,找备注里含"续费"的记录
SELECT id, remark FROM orders WHERE remark LIKE '%续费%';
这两段分别演示了两种模式。写法一在 phone 有索引时效率很高;写法二因为左边是 %,即使 remark 有索引也多半用不上,记录多时会明显变慢。验证查询效果时,可以用 EXPLAIN 检查是否走了索引,再决定要不要改写法或加全文索引。常用通配符记不住时,MySQL 速查手册 可以随手翻,快速对照语法。如果模糊查询是产品的核心功能(比如搜索框),但数据量大,优先考虑数据库的全文索引或独立的搜索引擎,LIKE 只适合偶发、量小的场景。
三、转义特殊字符:查含 % 或 _ 的内容
当你要找的本身包含 % 或 _(比如折扣字段里的"50%"、SKU 里的下划线)时,直接写 LIKE '%50%%' 会被当成通配符而查错。这时要用 ESCAPE 指定一个转义字符,告诉数据库"紧跟在它后面的 % 或 _ 是普通字符"。
-- 查找描述里包含字面量"50%"的记录,反斜杠后的 % 不再是通配符
SELECT * FROM products WHERE description LIKE '%50\%%' ESCAPE '\';

-- 查找 SKU 里包含下划线本身的记录
SELECT * FROM sku WHERE code LIKE '%\_%' ESCAPE '\';
上面两段把 % 和 _ 还原成了普通字符。运行后第一段只返回真正含"50%"的行,而不是"任意字符后跟 50 加任意字符";第二段精确命中含下划线的 SKU。若忘记写 ESCAPE,查询会返回大量无关结果,排查时先检查是不是通配符没转义导致匹配范围被放大。
四、边界、性能与版本差异
SQL 模糊查询最容易踩的坑是性能:左侧通配符(%abc)几乎必然全表扫描,数据量到百万级时延迟会陡增。适用场景上,短前缀、固定格式字段(手机号、订单号前几位)适合 LIKE;长文本检索更适合数据库的全文索引或专用搜索引擎。
版本方面,MySQL 教程 提到 MySQL 8.0 与原生 MariaDB 的 LIKE 行为一致,均区分大小写取决于列的排序规则;PostgreSQL 的 ILIKE 提供不区分大小写版本,标准 SQL 的 LIKE 则区分。排错时先确认字段的字符集与排序规则,再判断为何"明明有数据却查不到"。另外,NULL 参与 LIKE 永远返回未知(不匹配),漏数据时要记得把 IS NULL 单独列出。排查失败时,先确认字段的字符集与排序规则是否一致;若左通配符导致全表扫描,修复办法是改用前缀匹配或加全文索引。
还有一个易忽视的语义陷阱:尾部空格。某些排序规则会忽略字符串尾随空格,导致 LIKE 'abc' 也能匹配 'abc ',这种"查得到却对不上"的情况在精确比对时要特别小心,必要时用 BINARY 前缀强制逐字节比较。
总结
SQL 模糊查询依赖 LIKE 运算符和两个通配符:百分号代表任意长度,下划线代表单个字符。三种核心写法带走:
- 前缀匹配
LIKE 'x%'适合开头定位,通常能走索引; - 包含匹配
LIKE '%x%'灵活但左通配符易引发全表扫描; - 查
%、_本身要用ESCAPE转义,否则会被当通配符。
下一步想补 SQL 基础,可以先过一遍 SQL 教程打底。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- 想对比不同数据库语法,Oracle 教程 覆盖了另一种实现思路;
- 看新版本特性,MySQL 8 教程 讲了 8.0 的相关能力;
- 之前那篇 SQL 查询笔记 从另一个角度讲了实战细节,适合延伸阅读。
常见问题
Q:为什么加了索引,LIKE 查询还是很慢?
A:多半是左通配符导致索引失效。像 LIKE '%手机%' 这种左边带 % 的写法,数据库无法从索引开头定位,只能全表扫描,数据量大时自然慢。
Q:LIKE 能查数字列吗?
A:LIKE 只对字符生效。数字列要先转成字符串(如 CAST(id AS CHAR))再匹配,但这样通常也用不上索引,建议改成范围或等值比较。
Q:% 和 _ 到底有什么区别?
A:百分号匹配任意长度(包括零个)字符,下划线只匹配恰好一个字符。比如 张% 能中"张""张三",张_ 只中"张三"这种两字且姓张的。