H3 错误处理
服务端代码的日常不是「一切正常」,而是「哪里出了什么问题、客户端该收到什么」。H3 把这件事收成两个动作:可预期的错误用 HTTPError 抛出,不可预期的错误自动兜底并隐藏细节。
这一节讲清错误对象的结构、错误响应的 JSON 长什么样、头部为什么在错误路径上会消失,以及全局钩子与中间件该怎么选。
用 HTTPError 表达可预期错误
HTTPError 有三种写法,选一种顺手的即可:
import { HTTPError } from "h3";

app.get("/error", (event) => {
  // 写法一:消息 + 状态码
  throw new HTTPError("Invalid user input", { status: 400 });

  // 写法二:静态方法,等价但更短
  throw HTTPError.status(400, "Bad Request");

  // 写法三:单个对象,字段最全
  throw new HTTPError({
    status: 400,
    statusText: "Bad Request",
    message: "Invalid user input",
    data: { field: "email" },
    body: { date: new Date().toJSON() },
    headers: {},
  });
});
上面第三种写法最终返回的状态是 400 Bad Request,响应体形如:
{
  "date": "2025-06-05T04:20:00.0Z",
  "status": 400,
  "statusText": "Bad Request",
  "message": "Invalid user input",
  "data": {
    "field": "email"
  }
}
注意两点:body 里的字段会被提升到响应的顶层(所以 date 出现在最外层),而 data 里的内容会完整保留在 data 键下。
八个字段各管什么
| 字段 | 作用 |
|---|---|
status |
HTTP 状态码,取值 200–599 |
statusText |
响应头里的状态文本 |
message |
错误消息,进 JSON 的 message |
data |
附加数据,进 JSON 的 data |
body |
附加的顶层属性,直接平铺到 JSON 顶层 |
headers |
额外响应头 |
cause |
原始错误对象,用于追踪与调试 |
unhandled |
是否属于「未知原因」的错误,见下节 |
⚠️
statusText有格式限制:长度要短(官方给的参考是 512–1024 字符以内),且只能含制表符、空格、可见 ASCII 与 128–255 区间的扩展字符。长消息放message,不要塞进statusText,否则可能被中间层截断或拒绝。
错误响应里的头部:为什么要单独设
先看清两条路径的差别,再谈怎么写:
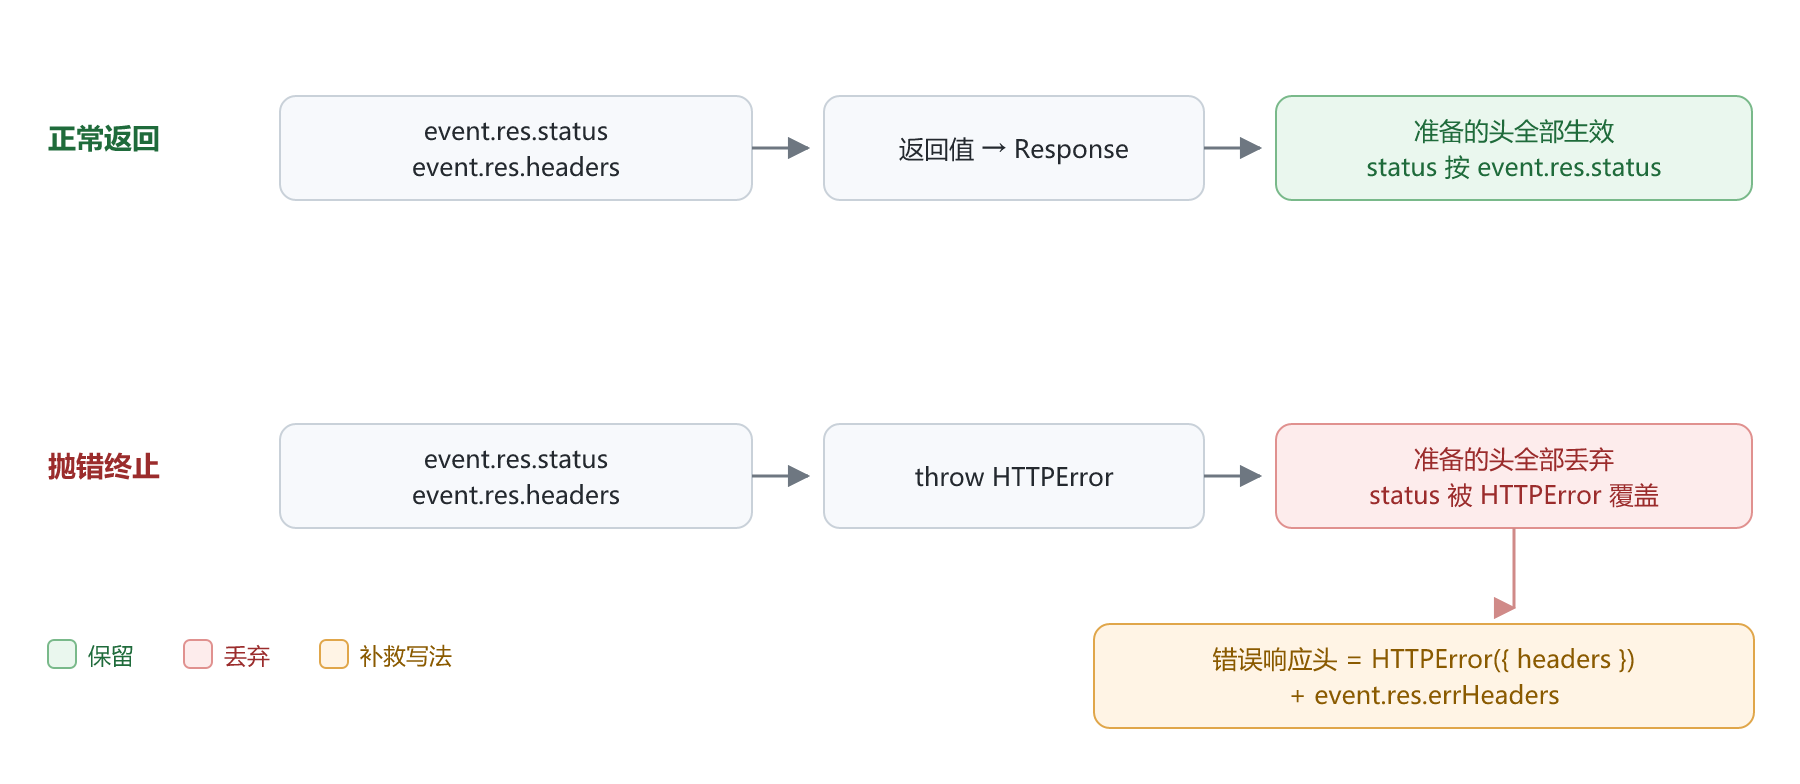
这是最容易踩的一处:
抛错时,你之前通过
event.res.headers准备的头部不会进入错误响应。
原因不难理解——错误意味着「之前的响应作废」,连同那些头一起作废。所以要给错误响应带头部,只有两条路。
首选:写在 HTTPError 上。
// 请求 ID 要出现在错误响应里,就挂在这里
throw new HTTPError({
  status: 400,
  message: "Invalid input",
  headers: { "x-request-id": requestId },
});
兜底:用 event.res.errHeaders。 适合那些「在错误发生之前就必须先设好、且无法预知会不会出错」的头部,典型就是 CORS:
// errHeaders 会自动合并进错误响应;正常响应不受影响
event.res.errHeaders.set("access-control-allow-origin", "*");
内置工具(如 handleCors)会同时设置两处,所以用它就不必自己操心。
未处理错误:会隐藏什么
任何不是 HTTPError 的错误都算「未处理」。为了安全,H3 会在 JSON 响应里隐藏这些字段:
| 被隐藏的字段 | 原因 |
|---|---|
message |
可能含内部实现细节、SQL、路径 |
data、body |
可能含内部数据 |
stack |
堆栈暴露文件结构与依赖版本 |
app.get("/boom", (event) => {
  // 未处理错误:客户端只看到通用信息,细节不会泄露
  throw new Error("数据库连接串:postgres://...");
});
这条设计的意义在于:你不需要记得手动清理错误信息,默认就是安全的。反过来,如果你确实想给客户端看具体原因,就必须用 HTTPError 显式声明——等于强制你确认「这句话可以让用户看到」。
在哪里捕获错误
有两种方式,选择取决于是否有嵌套应用。
方式一:应用级 onError 钩子
import { H3, onError } from "h3";

// 在构造应用时传入,属于全局钩子
const app = new H3({
  onError: (error) => {
    console.error(error);
  },
});
方式二:onError 中间件
import { onError } from "h3";

// 注册成中间件,作用范围跟随注册位置
app.use(
  onError((error, event) => {
    console.error(`[${event.url.pathname}]`, error);
  }),
);
💡 有嵌套应用时优先用中间件:子应用的全局钩子不会被调用。如果你的项目用
app.mount()拼了多个子应用(见 2.7),钩子只挂在主应用上,子应用内部抛的错到不了它的onError;而中间件只要注册在能覆盖该路径的层级上,就能看到。
两种方式都只是「观察」——写日志、上报、打点。不要试图在钩子里改响应内容,要在客户端看到什么,直接用 HTTPError 定义。
一套可用的错误分层
实际项目里建议按「谁的问题」分三层,状态码不要乱用:
// 1. 客户端参数问题 → 4xx,把具体字段告诉用户
if (!email) {
  throw new HTTPError("缺少 email 参数", {
    status: 422,
    data: { field: "email" },
  });
}

// 2. 资源不存在 → 404,不要用 400 混淆
if (!user) {
  throw new HTTPError("用户不存在", { status: 404 });
}

// 3. 依赖故障 → 5xx,对外只说「稍后再试」,细节进 cause
try {
  await callUpstream();
} catch (cause) {
  throw new HTTPError("上游服务不可用", { status: 503, cause });
}
cause 不会出现在响应里,但会进日志,这是保留排查线索又不泄露给用户的正确姿势。
v1 迁移对照
| v1 | v2 |
|---|---|
createError() |
new HTTPError() / HTTPError.status() |
H3Error |
HTTPError |
isError(err) |
HTTPError.isError(err) |
排查表
| 现象 | 原因 |
|---|---|
客户端看到 {"status":500,...} 但没有具体消息 |
抛的是普通 Error,属于未处理错误,message 被隐藏 |
| 错误响应缺 CORS 头,浏览器报跨域 | 准备头被丢弃,需用 errHeaders 或 HTTPError({ headers }) |
| 子应用里的错误没有进日志 | 用了全局钩子,但错误来自挂载的子应用,改用 onError 中间件 |
statusText 被截断或不生效 |
文本过长或含非允许字符,改把内容放 message |
延伸阅读
- 响应头在正常路径与错误路径的不同行为:见 2.5 发送响应
onError中间件的注册与参数顺序:见 2.3 中间件- 嵌套应用的钩子隔离问题:见 2.7 嵌套应用
- 完整弃用清单:见 8.2