
Qwen 的上下文和文件边界在哪
先记上限再谈长文:qwen3.7-max 的 1,000,000 tokens 是窗口上限不是配额,输入、输出、思维链各有各的顶;长文档按片段投喂、写清边界契约,比整本硬塞稳定。
一、前提与适用
| 适用对象 | 前提 | 不适用 |
|---|---|---|
| 要喂长文档给模型的人 | 知道文档总字数,能做分段 | 只聊一两句日常问答,上下文远未吃紧 |
| 准备写跨多轮的资料核对任务 | 有明确的核对问题清单 | 想做向量检索、知识库系统选型 |
| 收到过「答非所问」「遗漏后半篇」的输出 | 模型名与接入端点已确定 | 网页端上传文件的场景(入口能力不同) |
本节按接口调用口径写,示例用 qwen3.7-max;示例参数 temperature=0.7、top_p=0.8 属选取默认值,不是官方推荐。能力数字以官方页实时值为准。
二、怎么做
三步:查上限 → 切片段 → 写边界契约。
第 1 步,查上限。 qwen3.7-max 的官方口径:上下文 1,000,000 tokens;最大输入 991,808 tokens、最大输出 131,072 tokens;思考模式下最大输入 983,616 tokens、思维链上限 262,144 tokens。三个数字要分开记:输入、输出、思维链不是共用一个池子,开了思考,输入上限还会再让出一截。
第 2 步,切片段。 上下文装得下不等于都该塞进去。无关片段会稀释注意力,也让计费 token 膨胀。按问题切:一次核对只投喂与问题相关的部分,每片给编号(第 1 部分,共 3 部分),跨片的结论等各片回完再合并。
第 3 步,写边界契约。 在提示词里写明「只依据给定片段回答,片段里没有的信息填未提及」。下面的判定器不调接口,只算一件小事:给定计划投喂的量,两种模式下还剩多少输入余量。
## EXPECT: plain_headroom=990808 thinking_headroom=982616
LIMITS = {"plain": 991_808, "thinking": 983_616}

def headroom(mode, planned):
    return LIMITS[mode] - planned

print(f"plain_headroom={headroom('plain', 1000)} thinking_headroom={headroom('thinking', 1000)}")
开工前先看一组反例与正例。
坏写法:
这份文档很长,你全部看一下,然后回答我的问题。「全部看一下」没有范围、没有边界。文档超长时后半篇容易被忽略,回答混入文档外常识时也无从核对——因为提示词没有约定「没有的怎么办」。
改写后的完整提示词:
你是资料核对助手。只依据下面给出的文档片段回答;片段里没有的信息一律回答「未提及」,不要推测;答案不超过 3 句。

文档片段(第 2 部分,共 3 部分):
{{片段文本}}

问题:{{核对问题}}
最小可跑填法:片段文本 填真实文档的一小节,例如「本工具支持导出 CSV 与 Excel 格式,单次导出上限 10 万行;PDF 导出仍在开发计划中,未开放使用」;核对问题 填「现在能用 PDF 导出吗?单次导出上限是多少?」。随请求参数:模型 qwen3.7-max、enable_thinking=false、temperature=0.7、top_p=0.8——核对类任务答案基本固定,关思考更稳也更省。
实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:以 1000 的计划投喂量为例,非思考模式余量 990808、思考模式余量 982616;两数之差正是开思考让出的输入空间。判定器核对的是「上限减计划量」的算术,上限数字变了先改 LIMITS,再核对正文。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
现在不能使用PDF导出,该功能仍在开发计划中且未开放使用。
单次导出上限为10万行。
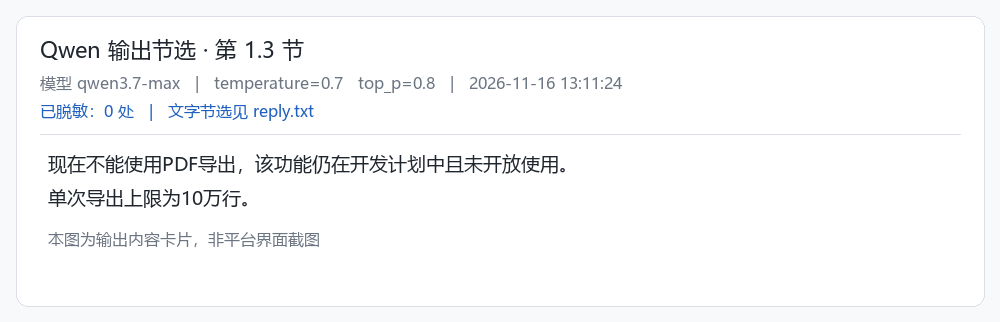
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 项 | qwen3.7-max 的行为 | 边界与注意 |
|---|---|---|
| 上下文窗口 | 1,000,000 tokens(官方页口径) | 数字随时调整,写进需求前回查 |
| 最大输入 | 991,808 tokens;思考模式 983,616 tokens | 开思考输入让位,长文核对可关思考 |
| 最大输出 | 131,072 tokens | 长摘要也要按需限长,超限会截断 |
| 思维链上限 | 262,144 tokens | 复杂推理任务留意这项,别只盯输出 |
| 文件上传入口 | 网页端与接口能力不同 | 本节只按接口口径写;平台侧入口另查 |
「上下文 1,000,000 tokens」不等于「每次都按这个量计费」:计费按实际投喂与产出计,投得少花得少。
四、验收清单
| 现象 | 判断依据 | 下一步动作 |
|---|---|---|
| 回答遗漏文档后半篇 | 投喂量逼近输入上限 | 切片段分轮投喂,每轮给编号 |
| 回答混入文档外常识 | 提示词没写「未提及」边界 | 补上边界契约,要求未提及就直说 |
| 片段回完后结论互相打架 | 跨片信息未合并 | 各片结论收集完,再发一轮合并指令 |
| 长核对任务费用偏高 | 无关片段被整篇投喂 | 按问题切片,只投相关部分 |
| 思考模式报输入超限 | 思考模式输入上限更小 | 对照判定器余量,或改关思考 |
用这张清单前先确认一点:上限数字以官方页当前值为准,正文里的登记值过期时先回查再判断。
五、注意与相关
- 三个上限(输入、输出、思维链)分开核对,别拿一个总数字代管三项。
- 「上下文装得下」与「应该装这么多」是两件事:无关内容稀释注意力,还多花 token。
- 切片编号(第几部分,共几部分)写进提示词,方便模型定位与后续合并。
- 来源:阿里云 qwen3.7-max 模型规格页
https://www.alibabacloud.com/help/tc/model-studio/qwen3-7-max给出上下文与输入输出上限;本节的切片与边界契约写法是教程为讲清「先定边界再投喂」自己组织的方案。 - 相关:思考开关取舍见 Qwen 思考开关该按什么选;输出契约写法见 把模糊要求换成 Qwen 能核对的约束;长文档的引用与不编造问法见 长文档怎么问 Qwen 才不编造。