
让 Qwen 归纳资料与对比观点
多文档归纳把每篇资料打上来源标签后一次性投喂——qwen3.7-max 的 1M 原生上下文(输入上限 991,808 tokens)装得下数十篇文档,一次归纳比逐篇轮询更少丢交叉信息;产出只报共识与分歧,不替读者下结论。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用任务 | 文献综述、多方观点汇总、评审意见归并、调研报告素材整理 |
| 官方依据 | qwen3.7-max 原生上下文 1,000,000 tokens,最大输入 991,808 tokens |
| 不适用 | 单文档摘要——没有多源对比需求,归纳结构是空转 |
| 核心手段 | 来源标签 + 逐篇摘要 + 共识/分歧两节 + 倾向性禁令 |
二、怎么做
归纳四步:打标签、逐篇摘要、分共识分歧、锁死结论。
- 每篇资料开头打来源标签。
[来源A]、[来源B]——标签让模型的每句归纳都能回指出处,也是你核对的抓手。文档多时标签按投喂顺序编,别用文件名当标签(太长且易错)。 - 先逐篇摘要再对比。「先逐篇摘要,每篇不超过 60 字,摘要必须带来源标签」——强制模型先独立读完每篇再比较,跳过这步容易把多篇内容搅在一起分不清谁说的。
- 输出结构固定为共识/分歧两节。共识 = 所有来源都支持;分歧 = 来源之间冲突。结构钉死后交叉关系一眼可见,比自由发挥的「总结」实用。
- 禁倾向性结论。「不得出现『综合来看』『建议采纳』,只陈述各来源说了什么」——研究场景里结论该由读者下,模型一旦给出倾向,读者容易把它当成事实而非归纳。
坏写法:
总结一下这几篇文章讲了什么。三处问题:「总结」没有输出结构(共识分歧混在一段散文里)、「这几篇」没有来源标签(观点归属无从核对)、「总结一下」允许模型下结论(倾向混进归纳)。
改写后的完整提示词:
你是研究助理。下面是三篇关于「远程办公效率」的短文,每篇开头已标注来源标签。请完成归纳:

1. 先逐篇摘要,每篇不超过 60 字,摘要必须带来源标签。
2. 再输出「共识」「分歧」两节:共识列所有来源都支持的观点;分歧列来源之间互相冲突的观点。
3. 分歧处的每一条都必须注明来自哪个来源标签(如 [来源B])。
4. 全文不得出现「综合来看」「建议采纳」等倾向性结论,只陈述各来源说了什么。

[来源A] 某团队报告:该团队实行每日两次固定站会,成员自评专注时间上升 20%。报告认为固定节奏是主因。
[来源B] 一项访谈研究:受访者普遍反映固定会议时段打断深度工作,自评专注时间下降。研究认为异步沟通更优。
[来源C] 一份工具调研:多数受访者表示效率感受与工具无关,主要取决于任务类型是否匹配工作时段。
标签、摘要约束、两节结构、结论禁令四件事齐备,模型只做归纳不做裁决。
「提示词是否具备归纳四要素」可以做成可跑检查:
## EXPECT: 来源标签=3 逐篇摘要=1 两节结构=1 倾向禁令=1
PROMPT = open("prompts/9.3.txt", encoding="utf-8").read()

import re
tags = len(re.findall(r"^\[来源[A-Z]\]", PROMPT, re.M))
summary = len(re.findall(r"逐篇摘要", PROMPT))
structure = int("「共识」「分歧」" in PROMPT)
ban = int("倾向性结论" in PROMPT)
print(f"来源标签={tags} 逐篇摘要={summary} 两节结构={structure} 倾向禁令={ban}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:来源标签按行首锚定命中 3 处(指令示例里的 [来源B] 是引用,不算数据行)、逐篇摘要 1 处、两节结构 1 处、倾向禁令 1 处——归纳四要素齐备。判定器只查提示词形态;分歧归属是否准确、结论是否中立,看下面的实测输出。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
[来源A] 团队实行每日两次固定站会,成员自评专注时间上升20%,认为固定节奏是提升效率的主因。

[来源B] 受访者反映固定会议打断深度工作致专注时间下降,认为异步沟通比固定会议更优。

[来源C] 多数受访者表示效率感受与工具无关,主要取决于任务类型与工作时段是否匹配。

共识
- 各来源均采用主观评价(自评专注时间或效率感受)作为衡量远程办公效率的指标。
- 各来源均认为远程办公效率会受到特定工作安排、沟通模式或任务匹配度等具体因素的影响。

分歧
- 固定会议/节奏对…(节选)
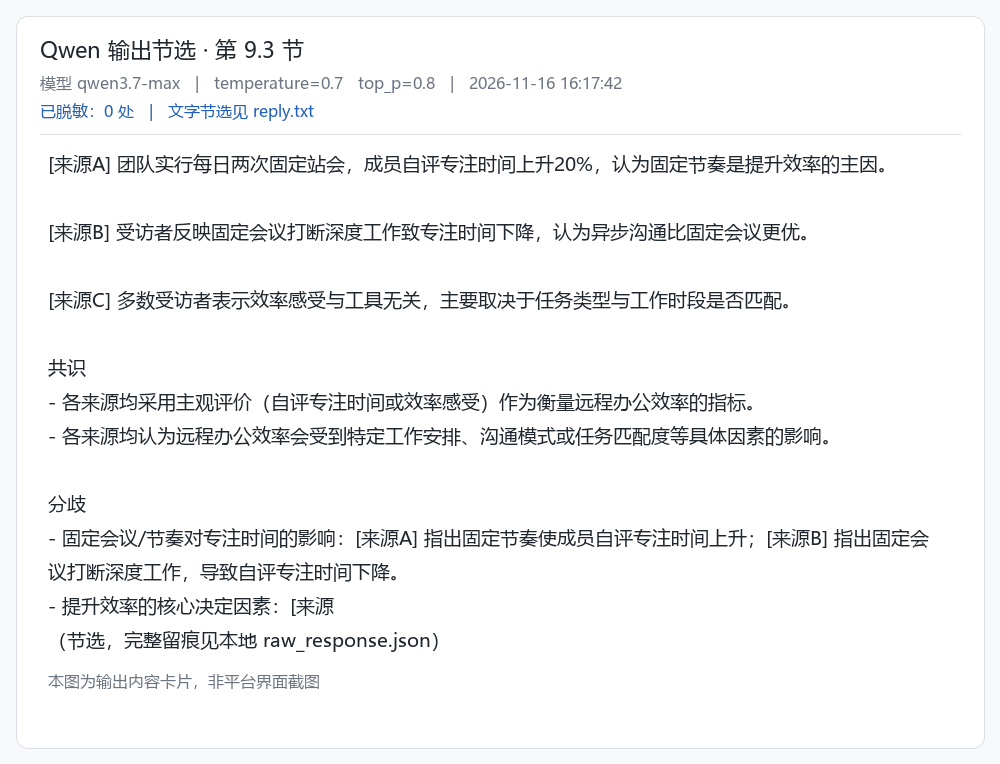
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 投喂量上限 | 输入上限 991,808 tokens(原生 1M 档);超量先离线筛源再投喂,不要指望模型「挑重点读」 |
| 思考模式差异 | 开思考时输入上限降为 983,616 tokens,长文投喂前确认开关状态 |
| 交叉信息 | 一次投喂能对比跨文档细节;逐篇轮询每次只见一篇,交叉点靠你自己拼 |
| 归纳保真 | 摘要与分歧条目仍需抽核原文——模型可能合并相近观点,标签只保证可回指,不保证零失真 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 观点可回指 | 每条分歧都带来源标签,按标签能找到原文 |
| 结构固定 | 输出严格按摘要 → 共识 → 分歧排列,没有自由发挥的「总结」段 |
| 结论中立 | 全文无「综合来看」「建议采纳」类倾向表述 |
| 停手条件 | 分歧条目把同一冲突拆成多条碎观点时,先在提示词里加「同一冲突合并为一条」,而不是继续加文档 |
五、注意与相关
来源标签是把「引用规范」压缩到提示词里的最小实现——正文的观点溯源、FDE 教程的编号引用、学术写作的引注,原理都是同一条:让每句结论能回到出处。1M 上下文窗口的另一面用法(长文档整读与切片取舍)见 长文档怎么问 Qwen 才不编造;摘要输出如果要结构化入库,字段规范见 让 Qwen 按字段 Schema 输出 JSON;多轮研究任务里归纳结果要随轮重述,跨轮沿用见 大需求怎么拆成 Qwen 多轮对话。