
让 Qwen 生成脚本与测试
让 Qwen 生成脚本与测试,关键不是把需求说得更客气,而是把输入契约、输出契约和断言条件写进提示词:先约定数据长什么样,再约定返回什么,最后约定怎样算跑通。
一、前提与适用
| 适用对象 | 前提 | 不适用 |
|---|---|---|
| 让模型生成数据处理代码的开发者 | 能描述真实数据的形状(表头、类型、空值) | 生产级工程(引号字段、编码、类型转换都要另补) |
| 要把生成的代码接进项目的人 | 能跑 Python,会看断言输出 | 只要一段演示代码、不打算验收 |
官方依据:Qwen 官方模型卡 Best Practices 给出标准化输出格式的写法(数学题逐步推理、答案放进指定记号;选择题在固定字段里只放选项字母),思路是「把怎么算合格写进提示词」,本节把它搬到脚本生成场景。
二、怎么做
三份契约逐项写进提示词:输入契约、输出契约、验收条件。
第 1 步,立输入契约。 写「只接收一个字符串」「首行是表头,含状态列」,而不是「处理 CSV」——模型就不会顺手加文件读取和命令行参数,字段名的歧义也一并收掉。
第 2 步,立输出契约。 写「返回字典,键固定为 total 与 by_status」,而不是「统计一下」——返回结构写进提示词,等价于给代码定了一个接口,生成结果可直接被别处调用。
第 3 步,立验收条件。 两个断言:一个覆盖空输入,一个覆盖正常数据的具体计数。前者是异常分支,后者是主路径;只写后者,代码遇到空表就崩,测试却照样绿。
下面是本地实跑的脚本,展示「契约写清之后,代码长什么样」,不是模型回复的抄录:
## EXPECT: total=3 | by_status={'done': 2, 'pending': 1}
import csv
import io
from collections import Counter

def summarize(csv_text):
    rows = list(csv.DictReader(io.StringIO(csv_text)))
    if not rows:
        return {"total": 0, "by_status": {}}
    return {"total": len(rows),
            "by_status": dict(Counter(r["status"] for r in rows))}

DATA = "id,status\n1,done\n2,pending\n3,done\n"

assert summarize("id,status\n") == {"total": 0, "by_status": {}}
assert summarize(DATA)["by_status"]["done"] == 2
r = summarize(DATA)
print("total=%d | by_status=%s" % (r["total"], r["by_status"]))
开工前先看一组反例与正例。
坏写法:
写个 Python 脚本处理 CSV,顺便加测试。「顺便」把测试降格成附属品,把三件本该先说清的事留给模型去猜:输入是路径还是文本、输出该打印还是返回、什么情况算通过。没有断言就没有「跑通」的定义,这类脚本在演示里好看,接进项目往往要重写。
改写后的完整提示词:
你是 Python 标准库助教。请写一个函数,统计一段 CSV 文本里的记录数与状态分布。

输入契约:函数只接收一个字符串,内容形如 {{样例输入}};首行是表头,含 {{状态列}} 这一列。
输出契约:返回一个字典,键固定为 total 与 by_status;by_status 按状态分组计数。
约束:只用标准库;空输入返回 total 为 0 且 by_status 为空字典;不要写解释,不要读写文件,不要解析命令行参数。
验收条件:随附两个断言,一个覆盖空输入,一个覆盖 {{样例输入}} 的预期计数;代码块首行用注释写明预期输出。
最小可跑填法:样例输入 填 id,status 表头加三行记录(1,done、2,pending、3,done),状态列 填 status。两个变量都有具体值,提示词才能整段复制运行。
实测输出与判定:脚本实跑输出 total=3 | by_status={'done': 2, 'pending': 1}。逐条判定:总记录数 3 与样例行数一致;状态分组与样例一致;空输入断言通过,零值分支没有漏掉。两条断言检查的是函数算出来的值,不是把预期抄进断言里再断言一次。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
## 预期输出: 空输入 -> {'total': 0, 'by_status': {}} ; 样例数据 -> {'total': 3, 'by_status': {'done': 2, 'pending': 1}}
import csv
import io
from collections import Counter

def count_csv_records(csv_text: str) -> dict:
    if not csv_text or…(节选)
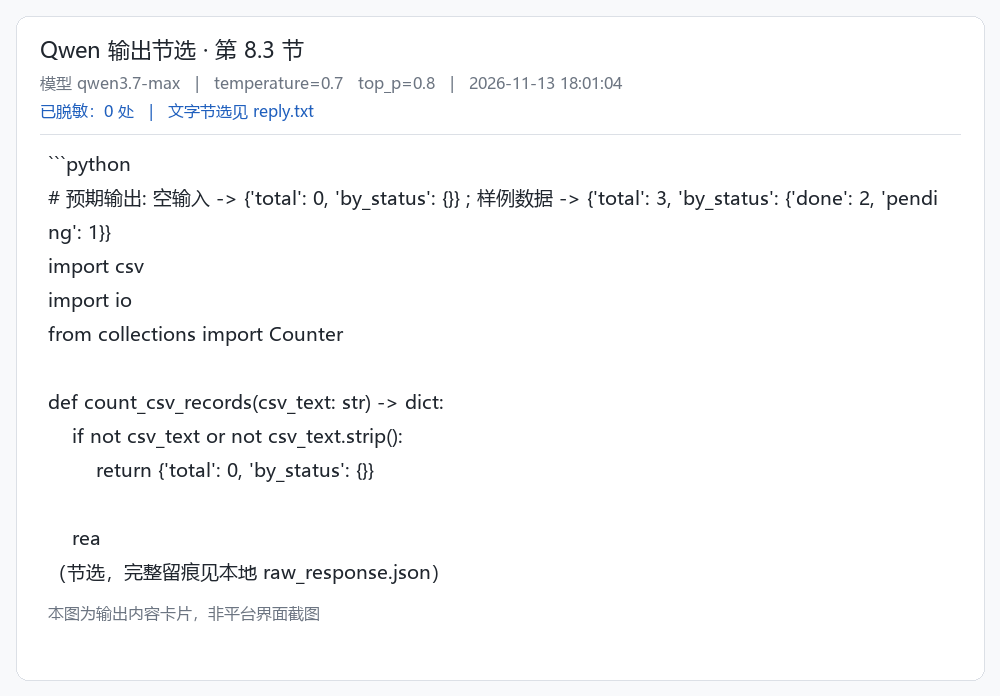
以上为模型真实回复的节选,实测日期 2026-11-13。
三、参数与边界
| 项 | 行为 | 边界与注意 |
|---|---|---|
| 空输入分支 | 返回 total=0 与空字典,不抛异常 |
要写进提示词,否则模型可能挑另一种「合理」做法,调用方处处判空 |
by_status 键顺序 |
来自样例数据里状态出现的先后 | 不当固定次序比对字符串;核键值对应,字典相等比较不受顺序影响 |
| 断言绑具体取值 | 样例 done 计数改为 3 时第二条断言先失败 |
断言保护这一份样例;改数据先改预期值,再谈改函数 |
缺 status 列的表头 |
Counter 取字段抛 KeyError |
这个异常防止缺列数据被静默少算;静默跳过比报错危险 |
| 「不要写解释」约束 | 压输出体积,解释会挤占输出长度 | 与见 控制 Qwen 输出篇幅与禁前言 的「禁前言」是同一类控制 |
两条边界:这段脚本示范的是契约的形状,不是 CSV 处理的完整方案——引号字段、编码差异、类型转换真实项目里都要补,补之前先确认输入契约有没有同步改(代码改了契约没改,下一条提示词会生成旧形状的函数);提示词写得再清楚也不保证代码一次就对,断言的作用是把「对不对」变成可跑的检查,不是替你保证结果。
四、验收清单
| 现象 | 判断依据 | 下一步动作 |
|---|---|---|
| 代码里出现没要求的读写 | 输入契约只写了「处理 CSV」 | 补数据源与参数形态,再生成 |
| 结果是打印而非返回 | 输出契约没定返回结构 | 写清返回的键与类型 |
| 空数据直接报错 | 验收条件只覆盖主路径 | 补一条零值分支断言 |
| 断言只是复述预期值 | 断言没有调用函数 | 改成调用后比较实际结果 |
| 解释文字挤占输出 | 没写禁前言类约束 | 补「不要写解释」,见 控制 Qwen 输出篇幅与禁前言 |
| 换了数据结果就偏 | 契约与代码改了不同步 | 先改契约,再改函数 |
用这张清单前先确认两点:断言是否真的调用了被测函数;输入契约描述的是不是你手上真实的数据形状。把契约当填空模板抄,生成的代码会精确地错。
五、注意与相关
- 「输入契约/输出契约/验收条件」的三分法是本教程对官方「标准化输出」思路的教学化改写,官方资料里没有这种分类,不代表官方要求这么分。
- 官方给出的采样参数与输出长度建议针对具体模型档位,切换思考开关或换模型档位时不能直接沿用;参数与事实值回查官方页再写进团队规范。脚本依赖的是标准库行为,通常不受官方页改版影响。
- 来源:Qwen3 模型卡 Best Practices
https://huggingface.co/Qwen/Qwen3-1.7B/raw/main/README.md(标准化输出格式写法);阿里云 Model Studio 提示词指南https://help.aliyun.com/en/model-studio/prompt-engineering-guide(「清晰具体」原则)。 - 相关:禁前言约束见 控制 Qwen 输出篇幅与禁前言;模糊要求换约束的四分法见 把模糊要求换成 Qwen 能核对的约束。