
Qwen 采样参数与成本
采样参数按「取值范围与默认值分列」的表来选——temperature ∈ [0,2)、top_p ∈ (0,1]、presence_penalty ∈ [-2.0,2.0](非思考默认 1.5、思考默认 0),思考模式禁贪心解码;官方只给范围与默认值不给「推荐值」,输出长度按官方评测口径选档:一般查询 32,768 tokens、竞赛级复杂题 38,912。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用场景 | 分类抽取要稳定、文案生成要多样、重复循环要压制、成本要估算 |
| 官方依据 | 官方只给参数取值范围与默认值,不给「推荐参数」硬值;输出长度 32,768/38,912 为官方评测口径建议 |
| 不适用 | 思考开关本身怎么用——那是 1.2 的主题,本节只管采样与长度 |
| 核心手段 | 参数表分列 + 任务→参数映射 + 输出长度分档 |
二、怎么做
参数选择三步:抄表、对任务、定长度。
- 参数表抄官方口径,范围与默认分列。temperature [0,2) 默认 0.7、top_p (0,1] 默认 0.8、presence_penalty [-2.0,2.0] 非思考默认 1.5 思考默认 0——本教程示例统一用 temperature=0.7、top_p=0.8,是选取默认值而非官方推荐硬值。
- 按任务性质映射。分类、抽取、要稳定的任务往低温度走;文案、头脑风暴要多样往高走;重复循环压 presence_penalty(0–2 区间内调,过高语言混杂、略降性能);思考模式禁贪心解码——官方明令贪心会性能下降并无限重复。
- 输出长度分档。一般查询建议 32,768 tokens 档,竞赛级复杂问题才上 38,912 档;qwen3.7-max 输出上限 131,072 tokens——上限是天花板不是目标值,按需给长度就是省钱。
坏写法:
帮我调一下参数,让输出又快又好又稳定。三处问题:「调一下」没有参数对象(temperature、top_p、penalty 混在一起)、「又快又好又稳定」三个目标互相冲突(高温度多样但摇摆、低温度稳定但呆板,没有优先级)、「帮我调」没有任务上下文(参数脱离任务无意义)。
改写后的完整提示词:
你是采样参数顾问。针对下面三个任务,从参数说明表里选参数并给输出长度建议。只从表里选值,不发明表外的「推荐值」。

参数说明表(取值范围与默认值分列):
| 参数 | 取值范围 | 默认值 | 备注 |
| temperature | [0, 2) | 0.7 | 越低越确定 |
| top_p | (0, 1] | 0.8 | 与 temperature 二选一调 |
| presence_penalty | [-2.0, 2.0] | 非思考 1.5 / 思考 0 | 0-2 可减少重复,过高语言混杂;思考模式禁贪心解码 |

任务:
1. 工单分类(要稳定,输出短)
2. 营销文案生成(要多样)
3. 长文摘要 + 摘要里出现了重复句式,想减少重复

输出要求:每个任务一行:任务、temperature、top_p、presence_penalty、输出长度档位(常规查询建议 32,768 tokens 档;只有竞赛级复杂题才上 38,912 档)、一句话理由。
参数表三行各带范围与默认、任务三个方向各异、长度分档钉死——「只从表里选值」堵死模型发明推荐值的路。
「提示词是否具备参数顾问三要素」可以做成可跑检查:
## EXPECT: 参数表行=3 任务行=3 长度档=2 范围声明=3
PROMPT = open("prompts/11.4.txt", encoding="utf-8").read()

import re
rows = len(re.findall(r"^\| (?:temperature|top_p|presence_penalty) \|", PROMPT, re.M))
tasks = len(re.findall(r"^\d\. (?:工单分类|营销文案生成|长文摘要)", PROMPT, re.M))
lens = len(re.findall(r"32,768|38,912", PROMPT))
ranges = len(re.findall(r"\[0, 2\)|\(0, 1\]|\[-2\.0, 2\.0\]", PROMPT))
print(f"参数表行={rows} 任务行={tasks} 长度档={lens} 范围声明={ranges}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:参数表三行、任务三行按行首锚定各命中、长度两档、范围声明三处——参数顾问三要素齐备。判定器只查提示词形态;参数是否只从表里选、长度档是否按任务给,看下面的实测输出。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
1. **工单分类** | temperature=0 | top_p=0.8 | presence_penalty=0 | 32,768 档 | 零温度确保分类结果完全确定可复现,输出极短无需重复惩罚。
2. **营销文案生成** | temperature=1.5 | top_p=0.8 | presence_penalty=1.5 | 32,768 档 | 高温度打开创意空间,配合默认惩罚值在多样与可读间取平衡。
3. **长文摘要减重复** | temperature…(节选)
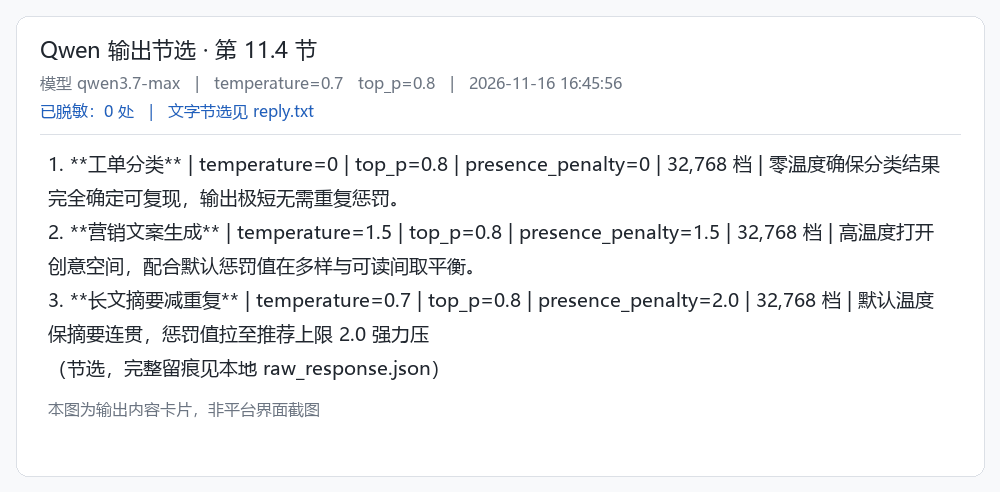
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 官方口径 | 参数只有取值范围与默认值;任何「官方推荐 0.5」类说法都无出处,选取默认值不等于官方推荐 |
| 思考模式 | 禁贪心解码(性能下降并无限重复);presence_penalty 思考模式默认 0,调参前先确认开关状态 |
| 重复压制 | presence_penalty 0–2 减重复,过高语言混杂略降性能;量化模型严重重复设 1.5 |
| 成本构成 | token 用量 = 输入 + 输出;输出长度档是成本主变量——能 32,768 档解决的不上更高档 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 值在范围内 | 每个参数都在官方取值范围内,无表外发明值 |
| 任务匹配 | 稳定型任务低温度、多样型任务高温度,方向没有拧反 |
| 长度有档 | 输出长度给出明确档位与理由,无「尽量长」类表述 |
| 停手条件 | 参数扫了两轮效果无差别,先回 11.3 排查根因——参数治重复与多样,治不了缺要素 |
五、注意与相关
参数表的纪律是「范围与默认值分列、绝不发明推荐值」——本教程全部实测统一在 temperature=0.7、top_p=0.8 上跑,就是选取默认值的自觉实践。三个参数各管一头:temperature/top_p 管随机性、presence_penalty 管重复、输出长度管成本。重复循环作为故障的处理流程在 11.3 诊断树;思考开关(enable_thinking)的取舍在 1.2;成本账(哪些操作在计费)见 哪些中文写法让 Qwen 输出不稳 的上下文边界。