
大需求怎么拆成 Qwen 多轮对话
一次让 Qwen 产出完整大件,各部分质量会互相拖累;按产出物拆轮次,每轮只交一个可验收的结果,后续轮只带相关上下文,历史里只留最终输出、不留思考内容。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用任务 | 「先调研再写」「先定结构再填充」「先抽取再汇总」这类有天然先后序的需求 |
| 不适用 | 一句话能说清的单点任务——拆轮次徒增往返 |
| 官方依据 | 官方模型卡多轮实践:历史中的模型输出只保留最终输出部分,不需要包含思考内容 |
二、怎么做
拆轮次三原则:
- 每轮一个产出物:第 1 轮定方案,第 2 轮出字段清单,第 3 轮写全文——每轮的提示词只描述一个可验收的交付,验收标准当轮写清(约束化见 把模糊要求换成 Qwen 能核对的约束)。
- 历史只带最终输出:进入后续轮次的对话历史,assistant 侧只放上一轮的最终答案,不贴思考过程。qwen3.7-max 的思考内容经 reasoning_content 返回,本来就是独立字段,拼历史时不要把它并进 content。
- 后期只带相关片段:轮次越靠后,越只带与当前产出物相关的早期结论,整段早期对话不必原样拖着走。
开工前先看一组对照。
坏写法:
帮我设计一个数据同步功能,包括方案选型、字段清单、接口定义和接入文档。四个产出物挤在一轮:方案还没定就开始写接口,字段与文档互相凑,任何一处返工全部重跑。
改写后的完整提示词(演示第 2 轮——第 1 轮已产出方案与字段清单):
你在一场多轮对话中。下面只给出上一轮的最终输出(思考过程已按规范移除,历史只保留最终输出)。

上一轮最终输出:
方案 A:同步模块采用增量同步,字段清单为 id、title、updated_at。

请基于上一轮的最终输出,只做一件事:为该字段清单补上每个字段的类型与说明,以 Markdown 表格输出,列:字段、类型、说明。不要复述方案背景,不要引入清单以外的字段。
一轮一个产出物,上一轮只带最终输出,思考内容已移除。
拼历史的动作容易漏删思考内容,判定器把「历史是否干净」做成可跑检查:
## EXPECT: assistant历史=2条 泄漏思考=0条
HISTORY = [
    {"final": "方案 A:增量同步,字段 id、title、updated_at", "thinking": "比较了三种同步策略"},
    {"final": "表格已输出", "thinking": "分析了表结构"},
]

def to_messages(history):
    return [{"role": "assistant", "content": h["final"]} for h in history]

msgs = to_messages(HISTORY)
leaks = sum(1 for m in msgs if "策略" in m["content"] or "分析" in m["content"])
print(f"assistant历史={len(msgs)}条 泄漏思考={leaks}条")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:两轮历史各取 final 字段构造成 assistant 消息;泄漏计数为 0,说明 thinking 内容没有混进历史。判定器按关键词抽查,生产代码直接丢弃 thinking 字段即可,不必依赖关键词。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
| 字段 | 类型 | 说明 |
| :--- | :--- | :--- |
| id | BIGINT | 记录唯一标识,用于增量同步时精确定位数据行 |
| title | VARCHAR(255) | 数据标题内容,随记录更新而变化,需纳入同步范围 |
| updated_at | DATETIME | 记录最后更新时间戳,作为增量同步的变更判断依据 |
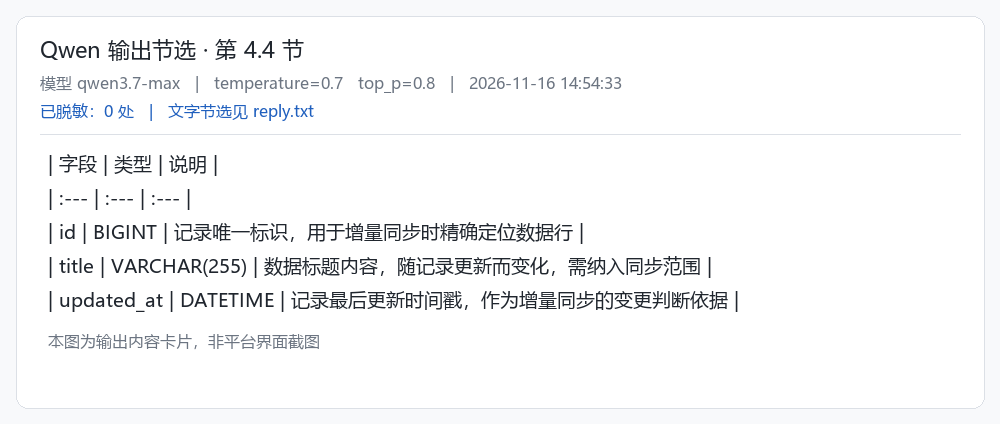
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 历史构造 | assistant 历史 = 最终输出文本;思考内容不进历史 |
| 上下文增长 | 多轮累计输入仍受 991,808 tokens 上限约束(见 Qwen 的上下文和文件边界在哪),超出先裁历史 |
| 轮间一致性 | 后续轮要显式重述关键契约(格式、字段),不依赖模型记住第 1 轮的原话 |
| 思考开关 | 拆方案轮可开思考;执行轮按 1.2 的取舍关掉 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 轮次可验收 | 每轮产出能单独判定对错,无「下一轮再说」的悬空交付 |
| 历史无思考泄漏 | 拼给下一轮的 messages 里检索不到思维链字样(判定器逐条扫描) |
| 上下文预算 | 累计输入留有输出余量,未顶到上限 |
| 停手条件 | 某轮产出连续 3 次不达标,先拆该轮而不是继续叠加 |
五、注意与相关
拆轮次解决的是质量互拖,不是上下文不够——单纯超长投喂先按 1.3 切片段。历史里漏删思考内容会让下一轮把推理过程当成要求复述;格式契约跨轮沿用时要逐轮重述(示例机制见 给 Qwen 几个例子才够)。多轮各自的真实调用留痕按 0.1 的口径逐轮记录。