
调试怎么给 Qwen 最小复现
调试提示词的命中率取决于给料完整性——报错全文不截断、环境一行说清、期望与实际并列、代码剥到最小可跑;官方「清晰具体」原则在调试场景的形态就是这四件套。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用任务 | 报错定位、异常行为归因、依赖冲突排查 |
| 官方依据 | Model Studio 提示词指南:构建清晰具体的提示词是发挥 LLM 能力最重要的一步 |
| 给料四件套 | 完整报错+环境信息+最小复现代码+期望与实际 |
| 不适用 | 需要看运行时内存/网络抓包的问题——模型只能推理,取证要靠本地工具 |
二、怎么做
给料四件套,逐样给足:
- 完整报错。traceback 从 Traceback 行到最后一行整段贴,不截中间帧——中间帧常是根因所在;「报错了」三个字不构成给料。
- 环境信息。语言版本、关键库版本、运行方式一行说清——同一报错在不同版本根因可能相反。
- 最小复现代码。剥掉与报错无关的业务逻辑,留下能稳定复现的最短代码;剥不动的先注释再验证「注释后仍复现」。
- 期望与实际。并列写「期望:返回 25。实际:报 TypeError」——没有期望值,模型连「对的标准」都不知道。
坏写法:
我的代码报错了,你看看怎么办?代码太长我就不全贴了,大概是类型的问题。四缺三:报错只凭转述、环境没有、代码没有、期望没写——「大概是」还替模型预设了方向。
改写后的完整提示词:
你是调试助手。下面是最小复现、完整报错与环境信息。请先定位根因,再给修复代码,最后说明为什么会这样。不要建议与根因无关的改动。

环境:Python 3.13,仅标准库

最小复现代码:
def total(prices, discount):
    return sum(prices) - discount

print(total(["10", "20"], 5))

完整报错(未截断):
Traceback (most recent call last):
  File "demo.py", line 4, in <module>
    print(total(["10", "20"], 5))
  File "demo.py", line 2, in total
    return sum(prices) - discount
TypeError: unsupported operand type(s) for -: 'int' and 'str'

期望:返回 25。
实际:报 TypeError。
四件套齐备,外加「不要无关改动」的范围约束。
「给料四件套是否齐」可以做成可跑检查:
## EXPECT: 报错全文=1 环境=1 期望实际=1 最小复现=1
PROMPT = open("prompts/8.2.txt", encoding="utf-8").read()

trace = int("Traceback (most recent call last):" in PROMPT and "未截断" in PROMPT)
env = int("环境:" in PROMPT)
pair = int("期望:" in PROMPT and "实际:" in PROMPT)
repro = int("最小复现代码" in PROMPT)
print(f"报错全文={trace} 环境={env} 期望实际={pair} 最小复现={repro}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:四项各命中 1 次,调试提示词给料完整。判定器只查给料形态;根因定位是否正确,看下面的实测输出并对照真实运行结果。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
## 根因定位

`prices` 列表中的元素是 **字符串** `"10"`、`"20"`,而非整数。

`sum()` 默认以 `0`(int)为初始值进行累加,`0 + "10"` 在 Python 中不合法,导致 `TypeError`。即便假设能拼接成字符串 `"1020"`,后续 `"1020" - 5` 同样不合法——字符串不支持 `-` 运算符。

## 修复代码

def total(prices, discount):
    ret…(节选)
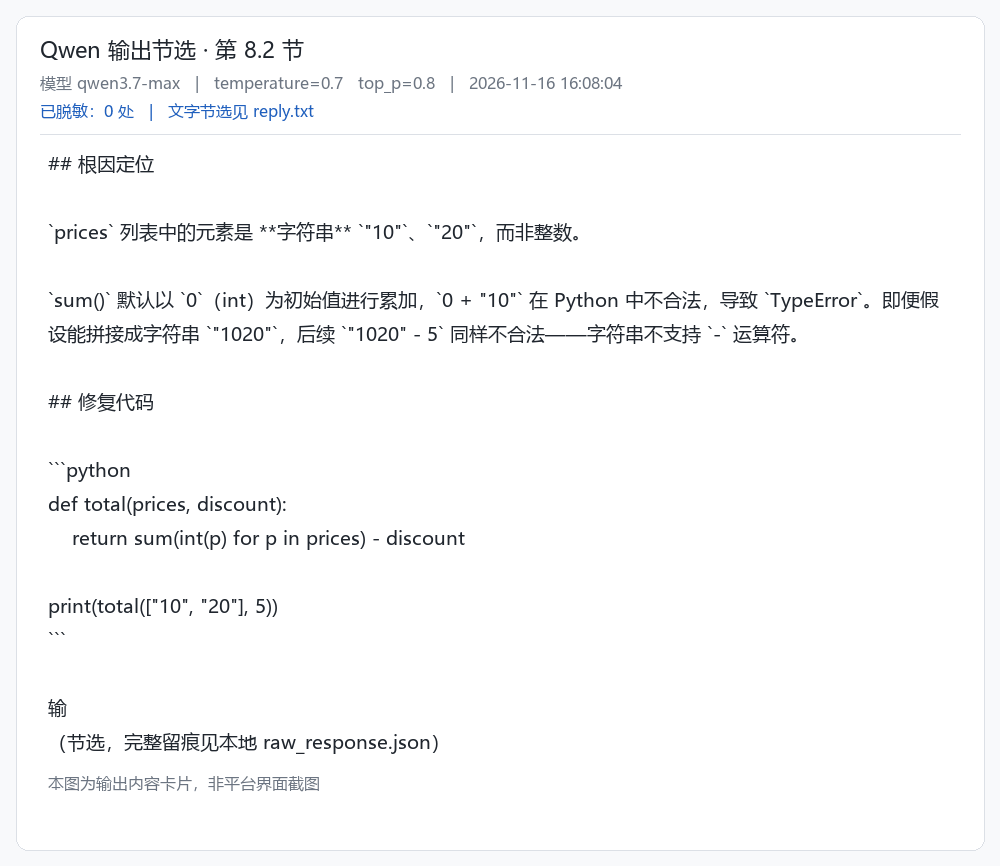
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 脱敏优先 | 报错与代码里常带内网地址、密钥——贴给任何外部服务前先脱敏 |
| 复现稳定性 | 偶现问题先找到稳定触发条件,拿不稳定复现提问会得到猜测式答案 |
| 版本敏感 | 涉及库版本的行为差异,让模型给「按版本分支」的答案而非单一结论 |
| 修复验证 | 模型给的修复必须本地实跑验证,通过标准与期望值并列复核 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 报错完整 | traceback 首尾完整,无手工省略的帧 |
| 复现最小 | 代码稳定复现且无无关逻辑 |
| 根因可验 | 模型指出的根因能解释期望与实际的全部差异 |
| 停手条件 | 两轮修复仍未通过,回到本地用二分注释定位,别继续加喂信息 |
五、注意与相关
最小复现是调试提示词的「资产」:剥出来的最小代码本身就是可复用的测试用例,修复后直接转成回归测试(写法见 让 Qwen 生成脚本与测试)。调试是行为取证,解释是文本分析——两者别混,解释代码的分层写法见 怎么让 Qwen 解释看不懂的代码;修复后的多轮追问规则见 大需求怎么拆成 Qwen 多轮对话;代码评审的维度化写法见 让 Qwen 评审重构与提交信息。