
Qwen 提示词团队规范与退役
模板库要有人管生死——能力基线升级(如上下文从 128K 到 1M tokens)触发全库复核,逐条判定继续用、需复核或退役;催生的新场景进「增量模板待建」清单。过期模板退役下架,而不是硬用到出错。 <!-- drift-ok --&
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用场景 | 团队模板库的定期体检、模型基线升级后的存量复核、新场景的增量规划 |
| 官方依据 | qwen3.7-max 原生上下文 1,000,000 tokens(输入上限 991,808)——能力基线升级是复核触发的典型事件 |
| 不适用 | 单人单模板——没有库就没有复核对象,管好版本(12.2)即可 |
| 核心手段 | 复核触发条件 + 三态判定 + 增量清单 |
二、怎么做
库管理三步:定触发、跑判定、记增量。
- 复核触发条件写死。三类事件触发全库复核:模型基线升级(上下文、输出上限、思考机制变化)、平台接口变更、业务标签集改版——写在库的 README 里,不靠有人想起来。
- 逐条三态判定。每条模板给结论:继续用(与新基线无关且回归稳定)、需复核(依赖被升级的能力,要在新基线上重跑回归)、建议退役(场景消失或被新写法替代)——三态比「是否可用」多了中间态,避免一刀切。
- 需复核的给复核动作。写清在哪个新基线上跑哪个回归集——「需复核」没有动作就是拖延;动作要指名回归集编号与基线版本。
- 增量场景进待建清单。基线升级会催生新写法(1M 上下文让整篇长文档直接归纳成为可能)——进「增量模板待建」清单排队立项,不挤进现有模板打补丁。
坏写法:
模板库里的提示词大家随便用,有问题再改。三处问题:「随便用」没有复核触发(能力基线升级后没人负责体检)、「有问题再改」是事后补救(带病模板会持续产出错误结果)、「大家」没有归属人(三态判定没人执行)。
改写后的完整提示词(库管理任务):
你是提示词模板库管理员。模型能力基线升级了(上下文窗口从 128K 升级到 1M tokens),请对库里三条模板逐条判定:继续用 / 需复核 / 建议退役,并说明理由。 <!-- drift-ok -->

三条模板摘要:
1. 长文档摘要模板 v1:说明里写着「模型最多支持 128K 上下文,超出需人工分段」。 <!-- drift-ok -->
2. 工单分类模板 v3:与上下文长度无关,纯分类任务,回归集稳定通过。
3. 多轮访谈整理模板 v2:逐段投喂逻辑复杂,1M 上下文后可以整篇投喂,但模板从未在 1M 模型上验证过。

判定要求:
1. 每条一行:模板名、判定(继续用/需复核/建议退役)、理由一句话。
2. 「需复核」的给出复核动作(在哪个新基线上跑哪个回归集)。
3. 若这次升级催生了新场景(如整篇长文档直接归纳),列一条「增量模板待建」清单项,不展开写模板本身。
触发事件写明、三条模板信息各异、三态判定与增量清单要求齐备。
「提示词是否具备库管理三步」可以做成可跑检查:
## EXPECT: 触发事件=1 三态选项=1 复核动作=1 增量清单=1
PROMPT = open("prompts/12.4.txt", encoding="utf-8").read()

import re
trigger = len(re.findall(r"能力基线升级", PROMPT))
states = len(re.findall(r"继续用 / 需复核 / 建议退役", PROMPT))
action = len(re.findall(r"复核动作", PROMPT))
growth = len(re.findall(r"增量模板待建", PROMPT))
print(f"触发事件={trigger} 三态选项={states} 复核动作={action} 增量清单={growth}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:触发事件、三态选项、复核动作、增量清单各命中 1 次——库管理三步齐备。判定器只查提示词形态;三条模板的判定是否合理、增量场景是否抓对,看下面的实测输出。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
长文档摘要模板 v1 | 建议退役 | 理由:硬编码的 128K 限制与人工分段逻辑已不适应 1M 窗口,继续使用会造成不必要的操作冗余与算力浪费。 <!-- drift-ok -->
工单分类模板 v3 | 继续用 | 理由:纯分类任务与上下文长度无关且回归集稳定通过,不受模型窗口升级影响。
多轮访谈整理模板 v2 | 需复核 | 理由:原复杂的逐段投喂逻辑可借 1M 窗口简化为整篇投喂,需在 1M tokens 新基线上跑「多轮访谈整理回归集」以验证简化后的效果。

增量模板待建:128K-1M 级别超长文…(节选) <!-- drift-ok -->
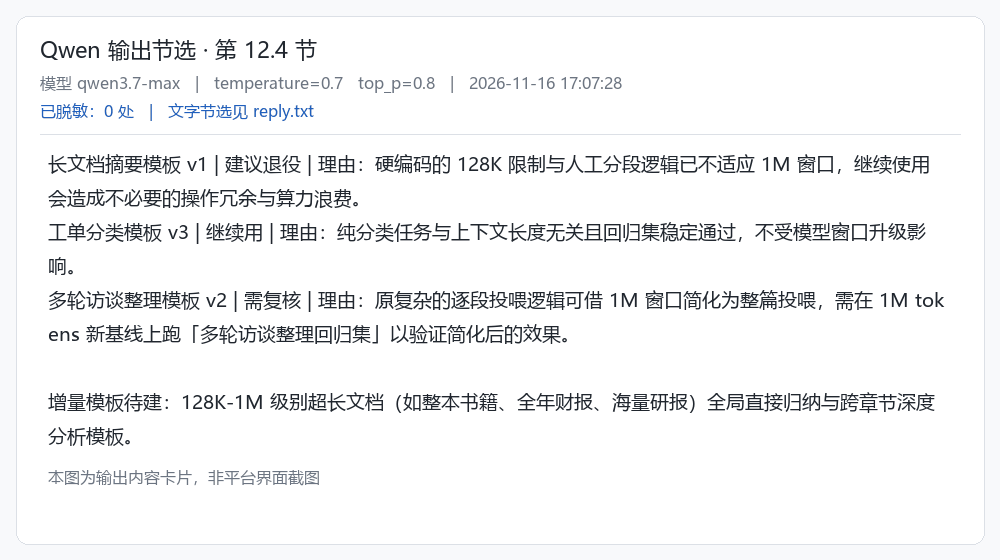
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 复核周期 | 无触发事件时按季度例行复核一次;触发事件优先于例行周期 |
| 三态比例 | 「需复核」占比过高说明基线升级冲击面大——分批复核而不是全库同时动 |
| 退役留痕 | 退役模板归档不删除:历史产出的追溯需要它,归档注明退役原因与替代模板 |
| 增量门槛 | 待建清单项要有使用频次估计与负责人,没有立项信息的清单项三个月后清理 |
四、验收清单
| 检查项 | 通过标准 | |
|---|---|---|
| 触发有档 | 库 README 里能找到复核触发条件与最近一次复核日期 | |
| 判定有据 | 每条三态结论引用了模板说明里的具体依赖(如「依赖 128K 上限声明」) | <!-- drift-ok --> |
| 动作可执行 | 需复核项指名回归集与基线版本,能直接派工 | |
| 停手条件 | 全库判定完仍无一条「退役」,复核可能走过场——抽查两条「继续用」的回归记录核真伪 |
五、注意与相关
模板库管理的本质是「把维护写成流程而不是觉悟」——触发条件、三态判定、增量清单三件套让体检变成可派工的任务。基线升级事件(上下文 128K→1M)的口径见 Qwen 的上下文和文件边界在哪;1M 上下文带来的整篇归纳新写法见 让 Qwen 归纳资料与对比观点;升级后要复核的参数手册见 Qwen 采样参数与成本。回归集是三态判定的证据来源,构建方法见 给 Qwen 做个小评测集;变更记录与版本号是判定时读的档案,纪律见 Qwen 提示词版本管理与回归。 <!-- drift-ok -->