
给 Qwen 做个小评测集
评测集不用大——20 到 50 条、分层抽样盖住真实分布、答案形态钉死(选择题只放字母、数学题放
\boxed{})、定稿后留作固定回归集不再改题;改提示词前后各跑一遍,分数升降就是回归结论。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用场景 | 提示词改版回归、标签集调整验证、模型或参数变更前后的对比 |
| 官方依据 | 官方评测口径:answer 只放选项字母、数学题逐步推理 + \boxed{}——评测答案形态与其对齐即可程序判卷 |
| 不适用 | 开放式生成任务的主观质量——没有标准答案,改用 11.1 的评分卡人工评 |
| 核心手段 | 分层抽样 + 答案形态契约 + 固定测试集 |
二、怎么做
评测集三件套:分层、钉形态、锁题库。
- 分层抽样盖住分布。「按四个标签各抽至少 1 条,其中其他类至少含 1 条表扬或闲聊」——分层保证每类都被考到;均匀随机抽 6 条可能全落在最大类,小类目零覆盖。
- 埋边界样本。「至少 1 条复合工单(两个诉求并存),用于考察主要诉求仲裁」——评测集专考容易错的边界,全放简单样本的评测集测不出回归。
- 答案形态钉死。expected_tag 只放标签文字、不放解释——与官方评测句式同一纪律:answer 只放选项字母(选择题)、数学题答案放
\boxed{}。形态钉死,判卷程序一个==就完成。 - 定稿后锁题。评测集一旦定稿就不许再改题——改题等于换考卷,改版前后的分数不可比。
坏写法:
随便给我一些测试用例,测试一下我的分类提示词好不好。三处问题:「一些」没有数量与分层约束(覆盖面随机)、「测试用例」没有答案字段(expected 与 output 混在一起没法判卷)、「随便」没有边界样本意识(全走简单路径)。
改写后的完整提示词:
你是评测集构建助手。为「客服工单四分类」(功能缺陷/体验问题/付费咨询/其他)设计一个 6 条的小评测集。

构建规则:
1. 分层抽样:按四个标签各抽至少 1 条,其中「其他」类至少含 1 条表扬或闲聊。
2. 至少 1 条复合工单(两个诉求并存),用于考察主要诉求仲裁。
3. 每条格式:{"id": "E01", "text": "工单内容", "expected_tag": "标签", "why": "一句话考察点"}
4. expected_tag 与工单一一对应,答案形态钉死为标签文字,不放解释。

只输出 6 条评测项,不要输出使用说明。
数量、分层、边界样本、答案形态四件事齐备,产出可直接落成回归脚本的数据文件。
「提示词是否具备评测集四要素」可以做成可跑检查:
## EXPECT: 分层规则=1 边界样本=1 答案形态=1 锁题约束=1
PROMPT = open("prompts/11.2.txt", encoding="utf-8").read()

import re
strata = len(re.findall(r"^1\. 分层抽样", PROMPT, re.M))
edge = len(re.findall(r"复合工单", PROMPT))
ans = len(re.findall(r"expected_tag.*不放解释", PROMPT))
lock = len(re.findall(r"只输出 6 条评测项", PROMPT))
print(f"分层规则={strata} 边界样本={edge} 答案形态={ans} 锁题约束={lock}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:分层规则、边界样本、答案形态、锁题约束各命中 1 次——评测集四要素齐备。判定器只查提示词形态;分层是否真盖住四类、复合工单是否埋进去,看下面的实测输出。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
[
  {
    "id": "E01",
    "text": "点击导出报表按钮后,页面一直转圈,最后提示502错误,完全无法下载数据。",
    "expected_tag": "功能缺陷",
    "why": "考察对明确系统报错和流程阻断等典型功能异常的识别。"
  },
  {
    "id": "E02",
    "text": "深色模式下的字体颜色太浅了,看着特别刺眼,而且二级菜单的折叠动画有些卡顿,希望能优化一下视觉效果。",
    "ex…(节选)
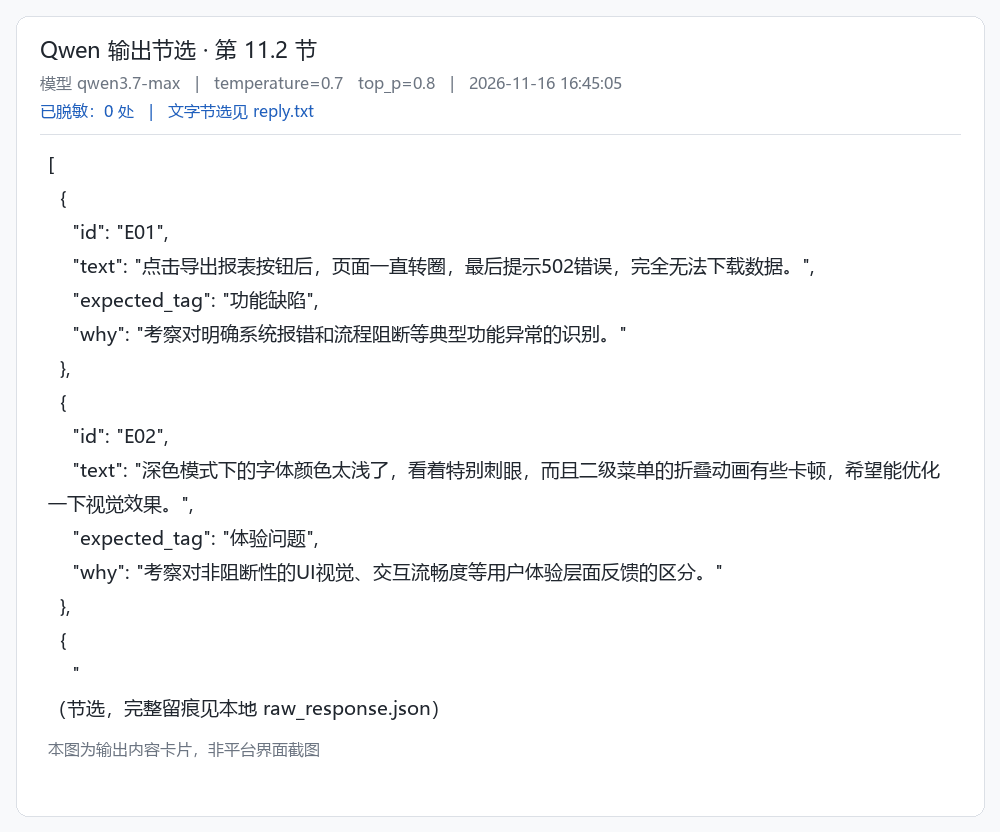
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 集合规模 | 20–50 条做日常回归足够;上限不是越多越好,判卷成本随条数线性涨 |
| 标准答案 | expected 由人工标注定稿;用模型生成初稿后必须人工逐条核对,错误答案会让回归结论反转 |
| 集合时效 | 业务标签集改版时评测集随之重标——但重标后旧分数作废,要跑一次基线重建 |
| 判卷方式 | 答案形态钉死后程序判卷;仍需人工看的只有「其他」类的拒判合理性 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| 覆盖完整 | 每个标签至少 1 条,抽查分布与真实业务占比方向一致 |
| 边界在场 | 评测集里能指出至少 1 条边界样本及其考察点 |
| 判卷可自动化 | 每条 expected 与输出形态一致,脚本一条循环跑完全集 |
| 停手条件 | 连续三轮分数不变,说明提示词已到该集合的天花板——加边界样本或换更难场景,而不是继续改措辞 |
五、注意与相关
评测集是「把验收标准变成可重放的数据」——与 5.3 判定器、11.1 评分卡构成完整的质量闭环:判定器查单条形态、评分卡查提示词文本、评测集查批量行为。答案形态的两条官方口径(选择题只放字母、数学题放 \boxed{})分别在 5.3 与 5.1 展开。分类标签集的设计纪律见 标签集怎么给 Qwen 不打架——标签集改版日就是评测集重标日。