
让 Qwen 信息抽取与表格化
抽取靠 Schema 钉字段——每个字段给类型与缺失值约定,多值进数组、缺失写 null;这条格式契约与官方评测句式(answer 字段只放选项字母)同源:出口形态钉死,下游程序才有稳定接口。
一、前提与适用
| 前提 | 说明 |
|---|---|
| 适用任务 | 合同要素抽取、简历入库、发票识别、报表数据整理 |
| 官方依据 | 官方模型卡评测句式:answer 字段只放选项字母——字段只装约定形态的值 |
| 不适用 | 原文语义模糊需要解释的场景——先澄清原文,再抽取 |
| 核心手段 | Schema 声明 + 缺失值约定 + 多值数组化 + 零解释输出 |
二、怎么做
抽取四步:Schema、缺失约定、多值处理、钉出口。
- Schema 写成「字段名 + 形态」。
{"party_a": "甲方名称字符串", "amounts": ["金额数字数组"], "signed_date": "签署日期或 null"}——每个字段声明装什么形态的值,模型照着装,程序照着取。 - 缺失值约定写死为 null。「字段缺失时写 null(或空数组),禁止猜测、禁止编造、禁止用『未知』等文字占位」——null 是程序可判定的形态,「未知」「无」是三种不同的人话,下游还得二次清洗。
- 多值一律进数组。「金额可能出现多笔,全部放进 amounts 数组」——把多值字段在 Schema 里就声明成数组,模型不会把第二笔金额挤进备注。
- 出口零解释。「只输出 JSON,不要任何解释文字」——抽取结果要进库,一句话解释都会让
json.loads报错。
坏写法:
把这份合同的关键信息提取出来。三处问题:「关键信息」没有字段清单(抽什么全凭模型判断)、「提取出来」没有缺失值约定(模型会把猜的日期填上)、「提取出来」没有输出形态(散文、表格、JSON 随机)。
改写后的完整提示词:
你是合同信息抽取器。从下面的合同片段抽取信息,严格按此 Schema 输出 JSON:

{"party_a": "甲方名称字符串", "amounts": ["金额数字数组,无则空数组"], "signed_date": "签署日期或 null"}

规则:
1. 字段缺失时写 null(或空数组),禁止猜测、禁止编造、禁止用「未知」等文字占位。
2. 金额可能出现多笔,全部放进 amounts 数组,按原文顺序。
3. 只输出 JSON,不要任何解释文字。

合同片段:
甲方:杭州某某科技有限公司。
本合同总服务费为人民币 48,000 元,分两期支付:合同签订后 10 个工作日内支付 60%,验收合格后支付剩余 40%。
本合同自 2026 年 3 月 15 日起生效,有效期一年。
Schema 三字段形态各异(字符串 / 数组 / 日期或 null),缺失与多值约定齐备,出口零解释。
「提示词是否具备抽取四要素」可以做成可跑检查:
## EXPECT: Schema声明=1 缺失约定=1 多值处理=1 零解释输出=1
PROMPT = open("prompts/10.2.txt", encoding="utf-8").read()

import re
schema = len(re.findall(r'^\{"party_a"', PROMPT, re.M))
missing = len(re.findall(r"禁止猜测", PROMPT))
multi = len(re.findall(r"放进 amounts 数组", PROMPT))
clean = len(re.findall(r"不要任何解释文字", PROMPT))
print(f"Schema声明={schema} 缺失约定={missing} 多值处理={multi} 零解释输出={clean}")实测输出与判定:脚本实跑输出与首行注释一致。逐条判定:Schema 声明、缺失约定、多值处理、零解释输出各命中 1 次——抽取四要素齐备。判定器只查提示词形态;分期金额是否全部入数组、缺失字段是否守 null 纪律,看下面的实测输出。
怎么看这个示例:判定器是本地脚本,上面那条提示词另在 qwen3.7-max(temperature=0.7、top_p=0.8) 上实测;脚本输出不等于模型输出,两者分别核对。
模型回复(真实输出节选):
{
  "party_a": "杭州某某科技有限公司",
  "amounts": [48000],
  "signed_date": null
}
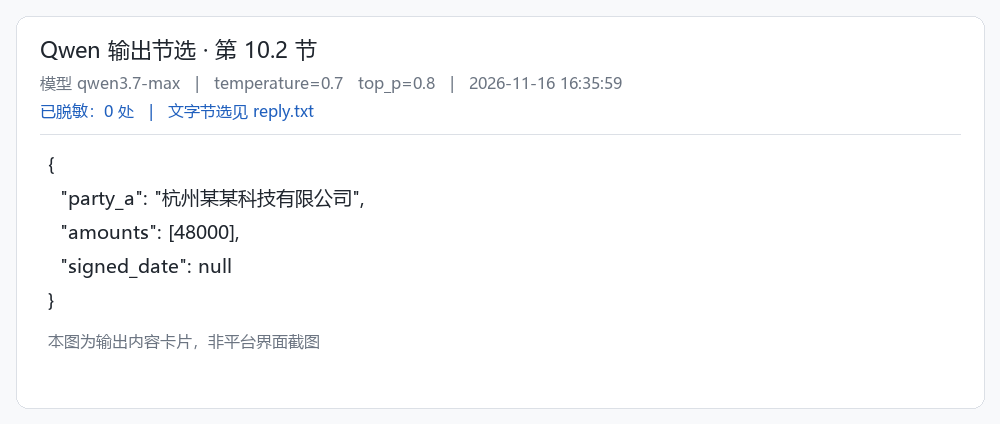
以上为模型真实回复的节选,实测日期 2026-11-16。
三、参数与边界
| 边界 | 说明 |
|---|---|
| 字段数量 | 单次 3–10 个字段为宜;超过 10 个按业务实体拆多次抽取,字段越多越易串位 |
| 派生值 | Schema 只装原文里有的值;「60% of 48,000 = 28,800」这类计算该由程序做,模型算术不可靠 |
| 嵌套深度 | 两层以内为宜;更深的结构改拆两条提示词分步抽取 |
| 缺失语义 | null 表示「原文没有」,与「原文写了但为空」含义不同;两者都要区分时在 Schema 里分开声明 |
四、验收清单
| 检查项 | 通过标准 |
|---|---|
| Schema 对齐 | 输出字段名与 Schema 逐字一致,无增无漏 |
| 缺失守约 | 缺失字段为 null/空数组,检索不到「未知」「无」类占位文字 |
| 多值完整 | 对照原文逐项核对数组元素数,无漏项无合并 |
| 停手条件 | 同一字段连续多篇抽取错误,先补字段说明或给一个期望样例,而不是加更多禁令 |
五、注意与相关
Schema 抽取与标签分类是同一件事的两个方向:分类收窄到单枚举值,抽取展开为多字段结构。字段约束的完整写法(含嵌套与枚举收窄)见 让 Qwen 按字段 Schema 输出 JSON 的 Schema;缺失值「不视为 0、不插值」的纪律在 6.2 的图片转录里已经出现过——数据类任务通用的第一条就是不许补数。抽取结果的质量抽检与错误率统计见第 11 章。